Apa Itu Embedding AI? Cara Kerja, Fungsi, dan Contohnya
Oleh
Ratna Patria
Pernahkah kamu menggunakan fitur pencarian yang tidak menemukan hasil relevan hanya karena kata yang diketik sedikit berbeda? Misalnya, pengguna mencari “laptop untuk desain”, sedangkan katalog menggunakan istilah “notebook untuk pekerjaan kreatif”. Sistem pencarian berbasis keyword murni bisa kesulitan menghubungkan kedua frasa tersebut.
Embedding AI membantu mengatasi masalah tersebut dengan merepresentasikan makna data dalam bentuk angka. Teknologi ini menjadi salah satu fondasi semantic search, sistem rekomendasi, chatbot berbasis dokumen, hingga Retrieval-Augmented Generation atau RAG.
Artikel ini akan membahas apa itu embedding AI, hubungannya dengan token dan vector, cara kerja dimensi embedding, metode similarity, serta penggunaannya pada sistem AI modern.
Apa Itu Embedding AI?
Embedding AI adalah representasi numerik dari teks, gambar, audio, atau jenis data lainnya yang dibuat oleh sebuah model. Representasi tersebut memungkinkan komputer membandingkan karakteristik atau makna suatu data menggunakan perhitungan matematis.
Cara termudah untuk memahaminya adalah dengan membayangkan sebuah peta. Setiap kata, kalimat, atau dokumen ditempatkan sebagai titik pada sebuah ruang matematis. Data yang dianggap memiliki karakteristik serupa oleh model cenderung mempunyai posisi yang lebih dekat dibandingkan data yang sangat berbeda.
Sebagai contoh, embedding untuk kata “mobil” kemungkinan memiliki hubungan yang lebih dekat dengan “kendaraan” dibandingkan dengan “makanan”. Model tidak menilai kemiripan berdasarkan susunan huruf, tetapi berdasarkan pola yang dipelajari selama proses training.
Komputer membutuhkan representasi semacam ini karena sistem komputasi bekerja dengan angka. Embedding menjadi salah satu cara untuk menerjemahkan informasi yang kompleks menjadi format numerik yang dapat dihitung dan dibandingkan.
Apa Fungsi Embedding AI?
Embedding memungkinkan sistem AI membandingkan data berdasarkan karakteristik yang dipelajari model. Kemampuan tersebut membuat embedding dapat digunakan dalam berbagai aplikasi yang membutuhkan pencarian, pengelompokan, atau rekomendasi.
Pada sistem pencarian, embedding dapat membantu menemukan dokumen yang relevan meskipun query tidak menggunakan kata yang sama persis. Pendekatan seperti ini disebut semantic search karena sistem berusaha mencari kesamaan makna, bukan sekadar kecocokan karakter.
Embedding juga dapat membantu sistem rekomendasi membandingkan karakteristik produk, konten, atau pengguna. Pada aplikasi AI berbasis dokumen, embedding sering digunakan sebagai bagian dari mekanisme retrieval untuk menentukan informasi yang perlu diberikan kepada model bahasa.
Konsep tersebut berkaitan erat dengan Natural Language Processing, khususnya ketika data yang diproses berupa bahasa manusia.
Perbedaan Token, Embedding, dan Vector
Token, embedding, dan vector sering muncul dalam pembahasan AI, tetapi ketiganya mempunyai fungsi yang berbeda.
Hubungannya dapat dipahami dari proses pemrosesan model bahasa. Teks biasanya lebih dahulu diproses menjadi token, kemudian model merepresentasikan token tersebut menggunakan embedding untuk menjalankan komputasi berikutnya.
Model embedding khusus juga dapat menghasilkan satu vector untuk sebuah kalimat, paragraf, atau dokumen. Karena itu, semua embedding umumnya direpresentasikan sebagai vector, tetapi tidak semua vector dapat disebut embedding.
Model bahasa besar atau LLM juga menggunakan representasi embedding dalam proses internalnya. Jika kamu ingin memahami bagian tersebut lebih jauh, pembahasan apa itu LLM dapat memberikan konteks mengenai cara model bahasa memproses input sebelum menghasilkan jawaban.
Bagaimana Cara Kerja Embedding AI?
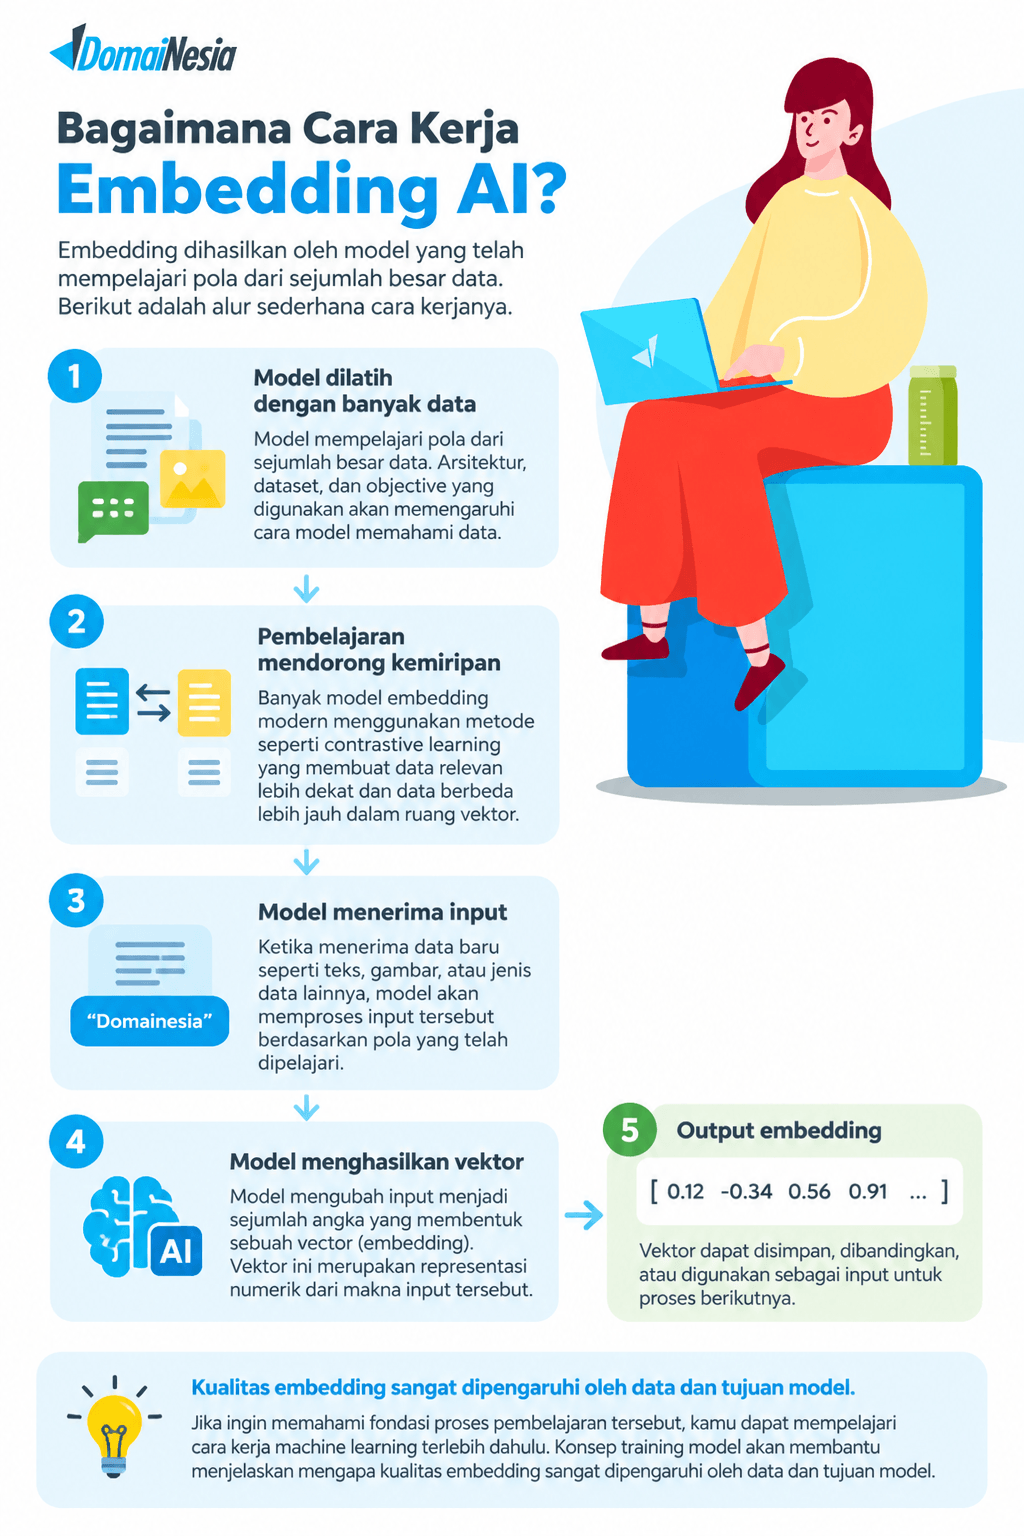
Embedding dihasilkan oleh model yang telah mempelajari pola dari sejumlah besar data. Cara model mempelajari representasi tersebut bergantung pada arsitektur, dataset, dan objective yang digunakan selama training.
Banyak model embedding modern menggunakan metode pembelajaran yang mendorong data relevan mempunyai representasi yang lebih dekat dan data yang berbeda berada lebih jauh. Contrastive learning merupakan salah satu pendekatan yang dapat digunakan, tetapi bukan satu-satunya metode untuk menghasilkan embedding.
Jika ingin memahami fondasi proses pembelajaran tersebut, kamu dapat mempelajari cara kerja machine learning terlebih dahulu. Konsep training model akan membantu menjelaskan mengapa kualitas embedding sangat dipengaruhi oleh data dan tujuan model.
Setelah model menerima input, model menghasilkan sejumlah angka yang membentuk sebuah vector. Vector tersebut kemudian dapat disimpan, dibandingkan, atau digunakan sebagai input untuk proses berikutnya.
Apa Itu Dimensi Embedding?
Dimensi menunjukkan jumlah nilai yang terdapat di dalam satu vector embedding. Sebuah embedding dengan 768 dimensi, misalnya, memiliki 768 angka yang membentuk representasi data tersebut.
Dimensi yang lebih besar memberikan kapasitas representasi yang lebih luas, tetapi jumlah dimensi tidak otomatis menentukan kualitas embedding. Arsitektur model, data training, objective, dan kecocokan model dengan tugas yang dikerjakan tetap mempunyai pengaruh yang besar.
Dimensi yang besar juga membutuhkan penyimpanan dan komputasi yang lebih banyak. Karena itu, developer biasanya memilih model embedding berdasarkan hasil benchmark dan kebutuhan aplikasi, bukan hanya berdasarkan jumlah dimensinya.
Bagaimana Similarity Antar-Embedding Diukur?
Setelah data diubah menjadi embedding, sistem dapat membandingkan vector untuk mengetahui tingkat kemiripannya. Proses tersebut menjadi dasar berbagai fitur seperti semantic search, rekomendasi, clustering, dan retrieval.
Salah satu metode yang sering digunakan adalah cosine similarity. Metrik ini membandingkan arah dua vector sehingga sistem dapat mengukur seberapa selaras representasi keduanya.
Selain cosine similarity, developer juga dapat menggunakan Euclidean distance atau dot product. Pemilihan metrik harus mengikuti karakteristik model embedding dan cara vector tersebut diproses.
- Cosine similarity membandingkan sudut atau arah antara dua vector dan sering digunakan pada embedding teks.
- Euclidean distance mengukur jarak geometris langsung antara dua titik di ruang vector.
- Dot product menghitung hasil perkalian antarvector dan banyak digunakan oleh sistem retrieval tertentu. Pada vector yang telah dinormalisasi, dot product dapat mempunyai hubungan yang setara dengan cosine similarity.
Sebagai contoh, query “laptop ringan untuk programmer” dan “notebook portabel untuk developer” tidak mempunyai banyak kata yang identik. Namun, model embedding yang sesuai dapat menghasilkan representasi yang cukup berdekatan karena kedua kalimat membawa konteks kebutuhan yang serupa.
🧠
Jalankan Backend Aplikasi AI dengan Kontrol Server yang Lebih Fleksibel
Jika kamu sedang mengembangkan API, vector database, worker, atau komponen RAG yang membutuhkan konfigurasi lingkungan sendiri, Cloud VPS DomaiNesia dapat digunakan sebagai salah satu pilihan infrastruktur server untuk menjalankan stack tersebut.
Peran Embedding AI dalam Semantic Search
Keyword search biasanya mencari kecocokan berdasarkan kata atau pola tertentu. Metode tersebut tetap sangat berguna ketika sistem membutuhkan kecocokan persis, seperti nomor produk, kode transaksi, nama file, atau istilah teknis tertentu.
Semantic search menggunakan pendekatan yang berbeda karena sistem mencari data berdasarkan kedekatan representasi makna. Query pengguna dan dokumen dapat diubah menjadi embedding, kemudian sistem mencari vector yang mempunyai tingkat similarity paling tinggi.
Pendekatan ini memungkinkan pencarian menemukan konten yang relevan meskipun query menggunakan sinonim atau susunan kalimat yang berbeda. Dalam implementasi nyata, keyword search dan semantic search juga dapat digabungkan menjadi hybrid search.
Peran Embedding AI dalam RAG
Retrieval-Augmented Generation atau RAG adalah pendekatan yang memberikan informasi tambahan kepada model sebelum model menghasilkan jawaban. Informasi tersebut biasanya berasal dari dokumen, knowledge base, database, atau sumber data lain yang dimiliki aplikasi.
Embedding sering digunakan pada tahap retrieval dalam sistem RAG. Namun, RAG tidak wajib menggunakan vector search karena developer juga dapat menggunakan keyword search, filter metadata, pencarian terstruktur, atau kombinasi beberapa metode.
Pipeline RAG berbasis vector secara sederhana dapat bekerja melalui tahapan berikut:
- Sistem membagi dokumen menjadi bagian yang lebih kecil apabila diperlukan.
- Model embedding mengubah potongan dokumen menjadi vector.
- Sistem menyimpan vector beserta data terkait ke penyimpanan yang mendukung pencarian vector.
- Pertanyaan pengguna juga diubah menjadi embedding menggunakan model yang sesuai.
- Sistem membandingkan embedding pertanyaan dengan embedding dokumen.
- Sistem mengambil bagian dokumen yang paling relevan.
- Aplikasi memberikan konteks tersebut kepada LLM sebelum model menghasilkan jawaban.
Penyimpanan dan proses pencarian pada tahapan tersebut sering menggunakan vector database. Vector database dirancang untuk menangani penyimpanan serta pencarian vector berdasarkan similarity secara efisien.
RAG dapat membantu model menjawab menggunakan informasi yang lebih spesifik daripada pengetahuan bawaan model. Namun, kualitas jawabannya tetap bergantung pada kualitas dokumen, strategi retrieval, prompt, serta model yang digunakan.
Jika kamu membangun pipeline tersebut secara mandiri, kebutuhan infrastrukturnya dapat mencakup API aplikasi, vector database, worker, serta layanan pendukung lainnya. Untuk lingkungan yang membutuhkan konfigurasi server lebih luas, kamu dapat menggunakan Cloud VPS DomaiNesia untuk menjalankan stack aplikasi AI sesuai kebutuhan resource aplikasi.
Contoh Penggunaan Embedding AI
Embedding sudah digunakan dalam berbagai jenis aplikasi. Implementasinya dapat berbeda karena masing-masing sistem menggunakan model, sumber data, dan algoritma retrieval yang berbeda.
1. Semantic Search
Website atau aplikasi dapat menggunakan embedding untuk mencari konten berdasarkan makna query. Sistem tersebut dapat menemukan dokumen relevan walaupun pengguna menggunakan istilah yang berbeda dari teks asli.
2. Rekomendasi Produk atau Konten
Embedding dapat merepresentasikan karakteristik produk, artikel, video, atau pengguna. Sistem rekomendasi kemudian dapat membandingkan representasi tersebut untuk mencari item yang dianggap relevan.
3. Chatbot Berbasis Knowledge Base
Chatbot dapat menggunakan embedding untuk mencari bagian dokumentasi yang berkaitan dengan pertanyaan pengguna. Informasi yang ditemukan kemudian dapat diberikan kepada LLM melalui arsitektur RAG.
4. Pencarian Gambar
Model multimodal dapat menghasilkan embedding untuk teks dan gambar dalam ruang representasi yang saling berkaitan. Kemampuan tersebut memungkinkan pengguna mencari gambar menggunakan deskripsi bahasa alami.
5. Clustering dan Deteksi Kemiripan
Embedding dapat membantu mengelompokkan dokumen yang mempunyai karakteristik serupa. Pendekatan tersebut dapat digunakan untuk pengelompokan konten, analisis data, maupun identifikasi dokumen yang sangat mirip.
6. AI Agent dengan Knowledge Base
AI agent dapat menggunakan mekanisme retrieval untuk mencari informasi yang dibutuhkan sebelum menjalankan suatu tugas. Embedding dapat menjadi salah satu komponen retrieval ketika knowledge base menggunakan semantic search.
Jika ingin mempelajari cara sistem semacam ini menjalankan tugas dengan tool dan informasi eksternal, kamu dapat melanjutkan ke pembahasan mengenai Agentic AI.
Kesimpulan
Embedding AI merupakan teknik untuk merepresentasikan teks, gambar, audio, atau jenis data lainnya menjadi vector numerik yang dapat diproses komputer. Representasi tersebut memungkinkan sistem membandingkan karakteristik data secara matematis sehingga pencarian tidak harus bergantung pada kecocokan kata secara literal.
Token, embedding, dan vector mempunyai peran yang berbeda. Token merupakan unit input yang diproses model, embedding merupakan representasi numerik yang dipelajari model, sedangkan vector merupakan bentuk matematis yang digunakan untuk menyimpan representasi tersebut.
Embedding menjadi komponen penting dalam semantic search, sistem rekomendasi, clustering, serta banyak implementasi RAG. Namun, kualitas sistem tidak hanya bergantung pada jumlah dimensi embedding karena model, dataset, retrieval strategy, dan infrastruktur aplikasi juga ikut menentukan hasil akhirnya.
FAQ Seputar Embedding AI

Ratna Patria
Hi! Ratna is my name. I have been actively writing about light and fun things since college. I am an introverted, inquiring person, who loves reading. How about you?