Cloud GPU: Pengertian, Cara Kerja, Kegunaan, dan Tips Memilih
Oleh
Hazar Farras
Pengembangan teknologi AI semakin membutuhkan kemampuan komputasi yang tinggi, terutama ketika developer melatih model deep learning, memproses dataset besar, atau menjalankan aplikasi AI dengan banyak permintaan. Sayangnya, perangkat lokal tidak selalu mempunyai GPU dan kapasitas memori yang sesuai untuk menangani pekerjaan tersebut.
Daftar Isi
Cloud GPU menjadi salah satu alternatif karena pengguna dapat mengakses kemampuan komputasi GPU melalui infrastruktur cloud tanpa harus membeli perangkat keras sendiri. Namun, tidak semua kebutuhan komputasi memerlukan Cloud GPU, dan memilih perangkat dengan spesifikasi tertinggi belum tentu menghasilkan biaya operasional paling efisien.
Misalnya, developer yang sedang menguji model AI sederhana mungkin masih dapat menggunakan GPU lokal atau layanan berbasis API. Sebaliknya, tim machine learning yang rutin melakukan training model dapat membutuhkan akses GPU dengan kapasitas VRAM lebih besar dan durasi penggunaan yang lebih panjang.
Artikel ini akan membahas pengertian Cloud GPU, cara kerjanya, jenis workload yang sesuai, spesifikasi yang perlu diperhatikan, hingga cara menghitung biaya dan menguji performanya sebelum memilih layanan.
Apa Itu Cloud GPU?
Cloud GPU adalah layanan komputasi berbasis cloud yang menyediakan akses ke Graphics Processing Unit (GPU) melalui infrastruktur server milik penyedia layanan. Pengguna dapat memanfaatkan resource tersebut untuk menjalankan aplikasi yang membutuhkan akselerasi komputasi, seperti artificial intelligence, machine learning, pemrosesan video, dan rendering grafis.
Berbeda dengan penggunaan GPU lokal, Cloud GPU tidak mengharuskan pengguna mempunyai perangkat fisik dengan GPU yang dibutuhkan. Penyedia cloud mengelola infrastruktur hardware, sedangkan pengguna mengakses resource komputasi melalui virtual machine, container, atau lingkungan komputasi lain yang disediakan.
Sebagai contoh, seorang developer ingin melatih model computer vision menggunakan ribuan gambar produk. Laptop yang digunakan mungkin mempunyai CPU yang memadai untuk pengembangan aplikasi, tetapi proses training memerlukan waktu terlalu lama karena kemampuan komputasinya terbatas.
Melalui Cloud GPU, developer tersebut dapat menjalankan proses training pada server dengan GPU yang sesuai. Setelah pekerjaan selesai, developer dapat menyimpan hasil training dan menghentikan resource komputasi sesuai ketentuan layanan.
Menurut dokumentasi GPU Google Cloud, GPU dapat digunakan untuk mempercepat berbagai workload, termasuk machine learning, komputasi ilmiah, aplikasi engineering, dan pemrosesan grafis.
Mengapa GPU Digunakan untuk Komputasi AI?
CPU dan GPU mempunyai karakteristik pemrosesan yang berbeda. CPU dirancang untuk menangani berbagai jenis instruksi dan tugas sistem, sedangkan GPU memiliki banyak unit komputasi yang dapat menjalankan operasi paralel secara efisien.
Pada deep learning, model melakukan berbagai operasi matematika, termasuk perkalian matriks dan pengolahan tensor. GPU yang kompatibel dapat mempercepat operasi tersebut ketika aplikasi dan framework mampu memanfaatkan kemampuan perangkat secara optimal.
Namun, GPU tidak selalu lebih cepat untuk setiap pekerjaan. Beberapa algoritma machine learning klasik, pemrosesan data kecil, dan aplikasi dengan banyak operasi berurutan tetap dapat berjalan secara efisien menggunakan CPU.
Jika kamu ingin memahami konteksnya lebih jauh, artikel perbedaan AI, machine learning, dan deep learning menjelaskan hubungan antara teknologi tersebut serta karakteristik penggunaannya.
Bagaimana Cara Kerja Cloud GPU?
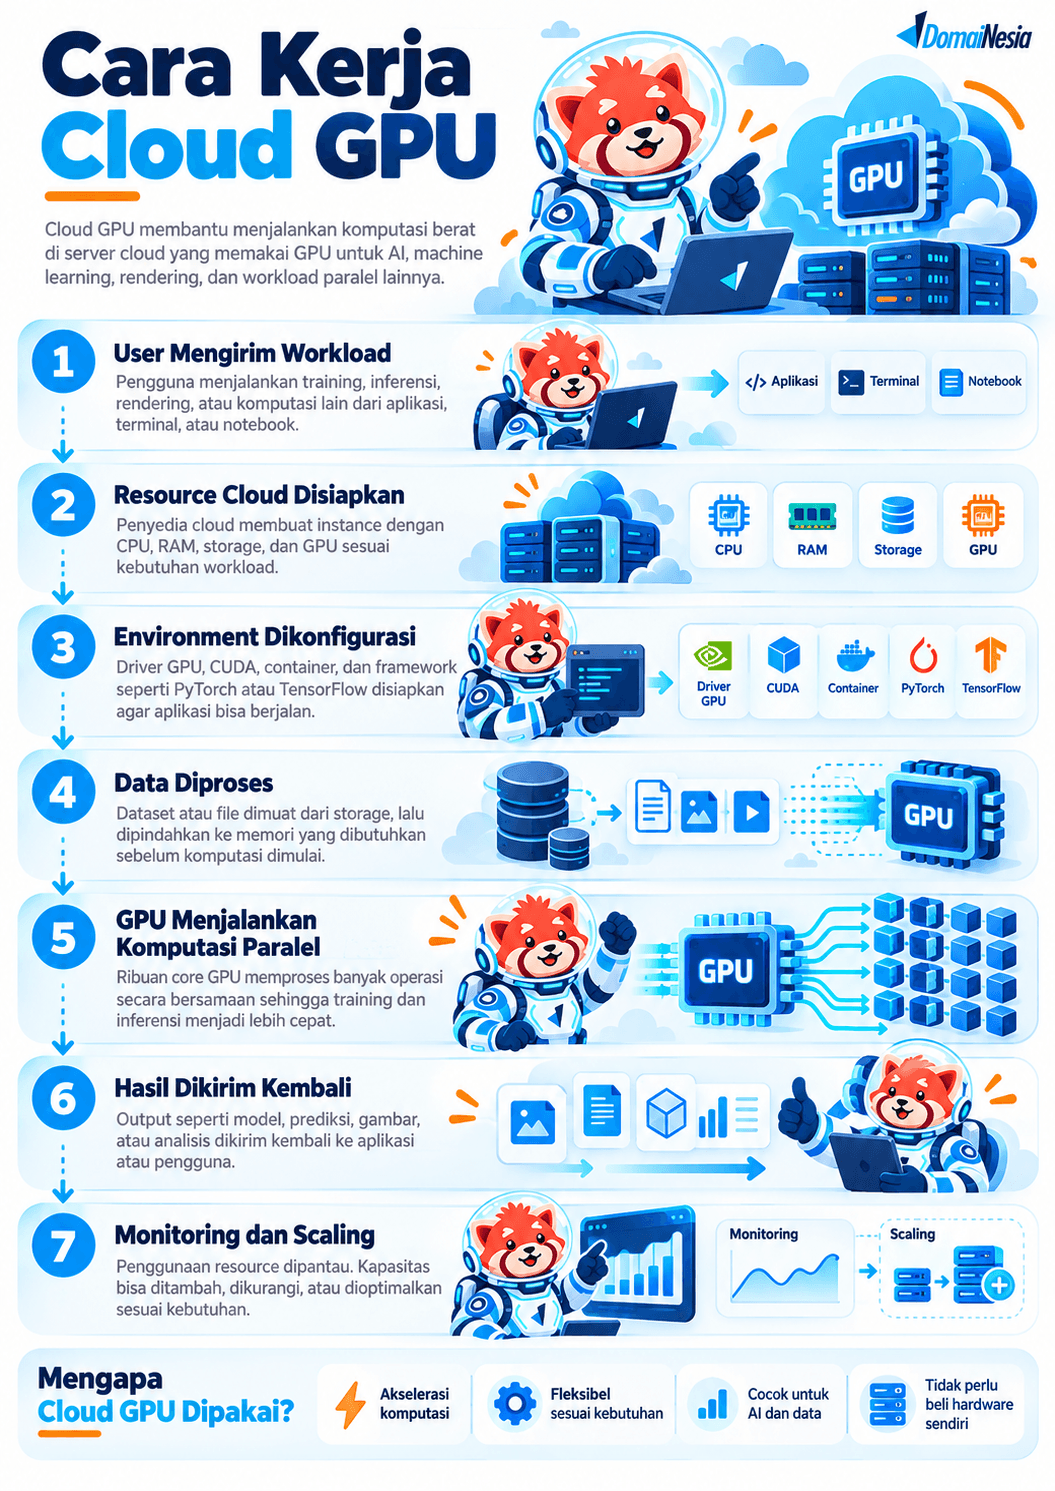
Cloud GPU bekerja dengan menyediakan resource komputasi GPU pada server yang berada di data center penyedia layanan. Pengguna kemudian memperoleh akses ke lingkungan komputasi yang dapat menjalankan aplikasi berbasis GPU melalui jaringan.
Walaupun proses provisioning berbeda pada setiap platform, alur penggunaan Cloud GPU secara umum melibatkan beberapa tahapan berikut.
1. Pengguna Memilih Spesifikasi GPU dan Server
Pengguna memulai proses dengan menentukan jenis GPU, kapasitas memori, jumlah vCPU, RAM, dan storage yang dibutuhkan.
Sebagian penyedia menawarkan GPU yang sudah menjadi bagian dari konfigurasi virtual machine. Penyedia lain memungkinkan pengguna memilih GPU tertentu sebagai komponen tambahan pada instance yang kompatibel.
Google Cloud, misalnya, menyediakan machine series yang sudah dilengkapi GPU dan beberapa pilihan instance yang memungkinkan penambahan GPU sesuai konfigurasi yang didukung.
2. Sistem Menyediakan Resource Komputasi
Setelah konfigurasi dipilih, platform cloud menyiapkan lingkungan komputasi menggunakan resource infrastruktur yang tersedia.
Pada konfigurasi tertentu, sistem memberikan akses langsung ke GPU melalui mekanisme passthrough. Pada konfigurasi lainnya, penyedia dapat menggunakan virtualisasi atau pembagian GPU untuk mendukung beberapa pengguna.
Karena model alokasi tersebut memengaruhi kapasitas dan isolasi resource, pengguna perlu memahami apakah layanan memberikan akses GPU penuh atau hanya sebagian resource perangkat.
3. Aplikasi Menggunakan GPU untuk Pemrosesan
Pengguna kemudian memasang atau menjalankan software yang dibutuhkan, seperti PyTorch, TensorFlow, library CUDA, atau aplikasi rendering yang kompatibel.
Ketika aplikasi menjalankan operasi yang mendukung akselerasi GPU, framework dapat mengirimkan pekerjaan komputasi ke GPU melalui driver dan runtime yang sesuai.
Sebagai contoh, PyTorch dapat menggunakan CUDA untuk menjalankan operasi tensor pada GPU NVIDIA yang didukung. Namun, pengguna tetap harus memastikan bahwa versi driver, runtime, dan framework mempunyai kompatibilitas yang sesuai.
4. Pengguna Menyimpan Hasil dan Mengelola Resource
Setelah pemrosesan selesai, aplikasi dapat menyimpan hasil training, checkpoint, model, atau file output pada media penyimpanan yang tersedia.
Pengguna selanjutnya dapat mempertahankan instance untuk pekerjaan berikutnya atau menghentikannya sesuai pola penggunaan.
Pada layanan berbasis pemakaian, tindakan menghentikan resource komputasi dapat membantu mengendalikan biaya. Namun, beberapa komponen seperti storage persisten tetap dapat dikenai biaya meskipun instance tidak sedang berjalan.
Kegunaan Cloud GPU untuk Berbagai Workload
Cloud GPU dapat digunakan untuk berbagai pekerjaan yang memanfaatkan pemrosesan paralel. Namun, manfaatnya bergantung pada karakteristik aplikasi dan kemampuan hardware yang digunakan.
Berikut beberapa contoh penggunaan Cloud GPU yang relevan dalam pengembangan teknologi modern.
1. Training Model Machine Learning dan Deep Learning
Training merupakan proses ketika model mempelajari pola dari data melalui pembaruan parameter secara berulang.
Sebagai contoh, sebuah perusahaan manufaktur ingin membuat model AI yang mampu mengidentifikasi cacat produk berdasarkan gambar. Tim pengembang perlu melatih model menggunakan kumpulan gambar yang telah diberikan label sesuai kondisi produk.
Ketika jumlah data, ukuran model, dan kompleksitas arsitektur meningkat, proses training dapat membutuhkan kemampuan komputasi yang lebih tinggi.
GPU dapat membantu mempercepat operasi tensor yang digunakan dalam training neural network. Namun, peningkatan performa aktual tetap dipengaruhi batch size, arsitektur model, konfigurasi framework, serta kecepatan penyediaan data.
Penjelasan lebih lengkap mengenai proses tersebut tersedia pada artikel pelatihan model AI, termasuk bagaimana data dipersiapkan dan digunakan untuk melatih model.
2. Menjalankan AI Inference
Inference adalah proses ketika model yang telah dilatih menerima input baru dan menghasilkan prediksi atau respons berdasarkan pola yang telah dipelajarinya.
Misalnya, aplikasi chatbot menerima pertanyaan pengguna dan meneruskannya kepada model bahasa untuk menghasilkan jawaban. Pada aplikasi computer vision, model dapat menerima gambar baru dan mengidentifikasi objek yang terdapat di dalamnya.
Cloud GPU dapat digunakan ketika model membutuhkan akselerasi komputasi atau ketika sistem perlu memproses permintaan dalam jumlah tinggi.
Namun, kebutuhan GPU untuk inference tidak selalu sama dengan kebutuhan training. Pengguna perlu mempertimbangkan ukuran model, jumlah permintaan bersamaan, target latensi, dan throughput yang ingin dicapai.
3. Fine-Tuning Large Language Model
Fine-tuning memungkinkan developer menyesuaikan model AI yang sudah dilatih sebelumnya menggunakan data tambahan yang relevan dengan tugas tertentu.
Sebagai contoh, perusahaan dapat melakukan fine-tuning pada model bahasa untuk meningkatkan kemampuannya memahami terminologi teknis yang digunakan dalam dokumen internal.
Metode seperti LoRA dan QLoRA dapat membantu mengurangi kebutuhan resource dibandingkan full fine-tuning pada kondisi yang sesuai.
Namun, proses fine-tuning tetap memerlukan perencanaan kapasitas VRAM, memori sistem, serta waktu komputasi. Model dengan jumlah parameter lebih besar biasanya membutuhkan resource lebih tinggi, meskipun metode optimasi dapat mengubah kebutuhan aktualnya.
4. Rendering Grafis dan Pemrosesan Video
Cloud GPU tidak hanya digunakan untuk pengembangan AI karena GPU juga memiliki kemampuan akselerasi grafis dan multimedia.
Studio animasi, misalnya, dapat menggunakan GPU untuk mempercepat rendering adegan yang kompleks. Sementara itu, aplikasi pemrosesan video dapat memanfaatkan encoder atau decoder hardware yang tersedia pada GPU tertentu.
Namun, tidak semua GPU menyediakan kemampuan encoding, decoding, dan akselerasi grafis yang sama.
Sebagai contoh, NVIDIA L4 memiliki hardware encoder dan decoder yang mendukung berbagai workload video. Karakteristik tersebut membuatnya relevan untuk sebagian pekerjaan multimedia selain inference AI.
5. Simulasi dan Komputasi Ilmiah
Cloud GPU juga dapat digunakan pada pekerjaan komputasi ilmiah yang memerlukan banyak perhitungan numerik.
Beberapa contohnya meliputi simulasi fisika, analisis data ilmiah, pemodelan teknik, dan komputasi berperforma tinggi atau High Performance Computing (HPC).
Pada workload tersebut, GPU dapat membantu mempercepat algoritma yang memiliki operasi paralel dan implementasi akselerasi yang sesuai.
Namun, kebutuhan precision, kapasitas memori, dan komunikasi antarperangkat dapat berbeda dibandingkan aplikasi AI. Karena itu, GPU yang baik untuk inference belum tentu menjadi pilihan paling efisien untuk seluruh pekerjaan komputasi ilmiah.
Perbedaan Cloud GPU, Cloud CPU, dan Dedicated GPU Server
Salah satu hal yang perlu dipahami sebelum memilih layanan adalah bahwa Cloud GPU, cloud server berbasis CPU, dan Dedicated GPU Server mempunyai karakteristik yang berbeda.
Perbedaan tersebut tidak hanya berkaitan dengan kemampuan komputasi, tetapi juga model alokasi hardware, fleksibilitas, dan biaya penggunaannya.
Perlu diperhatikan bahwa istilah dedicated merujuk pada alokasi resource sesuai ketentuan layanan, bukan jaminan bahwa seluruh aspek operasional akan dikelola oleh penyedia.
Cloud GPU juga dapat menawarkan akses ke GPU penuh sehingga perbedaannya dengan Dedicated GPU Server tidak selalu terletak pada eksklusivitas GPU saja.
Beberapa penyedia memungkinkan satu GPU fisik digunakan oleh beberapa lingkungan komputasi dengan teknologi tertentu.
NVIDIA, misalnya, menyediakan teknologi Multi-Instance GPU (MIG) pada perangkat yang kompatibel. Teknologi tersebut memungkinkan GPU dibagi menjadi beberapa instance dengan alokasi resource komputasi dan memori yang terisolasi.
Namun, tidak semua layanan virtual GPU menggunakan MIG atau menyediakan tingkat isolasi yang sama.
Karena itu, pengguna perlu memeriksa mekanisme pembagian GPU, kapasitas resource yang dialokasikan, serta pembatasan performa yang berlaku.
Untuk memahami konsep tersebut, kamu dapat membaca pembahasan mengenai virtualisasi GPU sebagai referensi tambahan.
Spesifikasi Cloud GPU yang Perlu Diperhatikan
Memilih layanan Cloud GPU sebaiknya dimulai dari kebutuhan aplikasi, bukan dari daftar GPU dengan spesifikasi tertinggi.
Beberapa komponen yang perlu diperiksa meliputi kapasitas VRAM, kemampuan komputasi, bandwidth memori, CPU, RAM, storage, dan konektivitas jaringan.
1. Kapasitas VRAM untuk Menampung Model dan Data
VRAM merupakan memori yang digunakan GPU untuk menyimpan data selama proses komputasi.
Pada workload AI, VRAM dapat digunakan untuk menyimpan bobot model, aktivasi, tensor, cache, dan data lain yang diperlukan selama training atau inference.
Kebutuhan VRAM tidak selalu sama dengan ukuran file model yang diunduh.
Sebagai contoh, model dengan 7 miliar parameter membutuhkan sekitar 14 GB memori hanya untuk menyimpan bobot jika setiap parameter menggunakan representasi FP16 sebesar 2 byte.
Namun, penggunaan aktual dapat melebihi angka tersebut karena sistem membutuhkan memori tambahan untuk runtime, cache, serta berbagai operasi pemrosesan.
Karena itu, GPU dengan VRAM 16 GB tidak otomatis cukup untuk menjalankan seluruh konfigurasi model 7B FP16 secara nyaman.
2. Jenis dan Generasi GPU
Setiap generasi GPU mempunyai karakteristik berbeda dalam hal kemampuan komputasi, bandwidth memori, efisiensi energi, dan dukungan teknologi tertentu.
Berikut beberapa contoh GPU NVIDIA yang sering digunakan sebagai referensi dalam pembahasan komputasi cloud.
Sumber spesifikasi: Google Cloud GPU Machine Types dan dokumentasi resmi NVIDIA L4. Kapasitas GPU yang tersedia dapat berbeda berdasarkan varian hardware dan konfigurasi penyedia.
Tabel tersebut tidak menunjukkan peringkat performa absolut karena setiap GPU mempunyai karakteristik berbeda.
Misalnya, GPU dengan kapasitas VRAM lebih besar belum tentu menghasilkan waktu inference lebih rendah untuk semua model. Performa aktual juga dipengaruhi arsitektur hardware, bandwidth memori, batch size, dan optimasi software.
3. Kemampuan Komputasi dan Memory Bandwidth
Kapasitas VRAM menunjukkan seberapa banyak data yang dapat ditampung oleh GPU. Sementara itu, memory bandwidth menunjukkan kemampuan perangkat memindahkan data antara unit komputasi dan memori.
Kedua spesifikasi tersebut berperan dalam menentukan bagaimana sebuah workload dapat dijalankan.
Sebagian aplikasi AI membutuhkan throughput operasi matematika yang tinggi, sedangkan workload lain lebih sensitif terhadap kemampuan perpindahan data.
Oleh karena itu, pengguna perlu melihat karakteristik aplikasi sebelum membandingkan angka komputasi yang ditampilkan dalam TFLOPS atau TOPS.
Perbandingan performa juga harus menggunakan precision dan kondisi pengujian yang setara agar hasilnya tidak menyesatkan.
4. CPU dan RAM sebagai Resource Pendukung
GPU tetap membutuhkan CPU dan RAM untuk menjalankan sistem operasi serta berbagai proses pendukung.
Pada training model computer vision, misalnya, CPU dapat digunakan untuk membaca gambar, melakukan preprocessing, dan menyiapkan batch sebelum data dikirim ke GPU.
Jika data loader terlalu lambat, GPU dapat mengalami waktu idle meskipun kapasitas komputasinya masih tersedia.
Karena itu, konfigurasi CPU dan RAM perlu disesuaikan dengan kebutuhan preprocessing, ukuran dataset, dan jumlah proses yang berjalan secara bersamaan.
5. Storage untuk Dataset dan Checkpoint
Storage digunakan untuk menyimpan sistem operasi, library, dataset, model, dan hasil pemrosesan.
Pada proses training, aplikasi juga dapat menghasilkan checkpoint secara berkala agar pekerjaan dapat dilanjutkan jika terjadi gangguan.
SSD NVMe sering dipertimbangkan untuk workload yang membutuhkan akses data dengan throughput tinggi dan latensi rendah.
Namun, kebutuhan storage tidak cukup dinilai berdasarkan jenis perangkat saja. Pengguna juga perlu memeriksa batas IOPS, throughput, kapasitas, dan apakah data tetap tersedia setelah instance dihentikan atau dihapus.
6. Konektivitas Jaringan dan Region
Cloud GPU bekerja melalui infrastruktur jaringan sehingga lokasi data dan kemampuan transfer menjadi pertimbangan penting.
Misalnya, sebuah tim menyimpan dataset berukuran besar pada penyimpanan di region tertentu. Menjalankan GPU pada region yang jauh dapat menambah waktu transfer dan biaya pemindahan data.
Namun, lokasi server yang paling dekat dengan pengguna tidak selalu menjadi pilihan paling efisien untuk seluruh pekerjaan.
Jika proses training lebih banyak mengakses dataset daripada melayani permintaan pengguna secara langsung, lokasi penyimpanan data dapat mempunyai pengaruh yang lebih besar terhadap efisiensi operasional.
Cara Memilih Cloud GPU Berdasarkan Kebutuhan
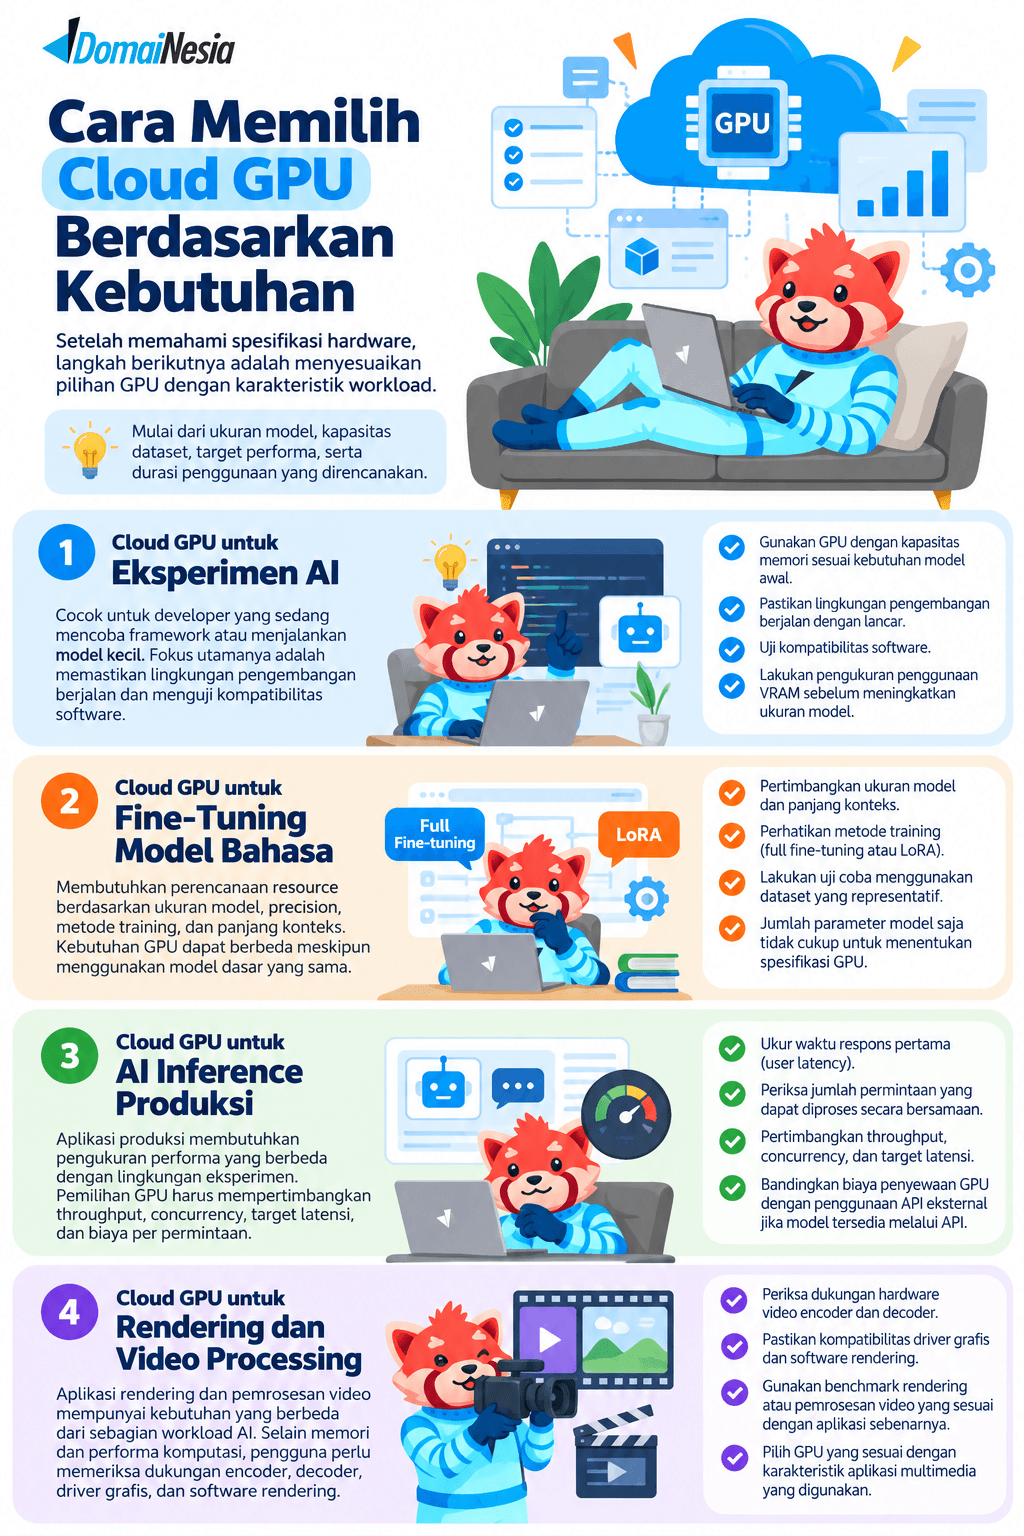
Setelah memahami spesifikasi hardware, langkah berikutnya adalah menyesuaikan pilihan GPU dengan karakteristik workload.
Kamu dapat memulai dari ukuran model, kapasitas dataset, target performa, serta durasi penggunaan yang direncanakan.
Cloud GPU untuk Eksperimen AI
Developer yang sedang mencoba framework atau menjalankan model kecil tidak selalu membutuhkan GPU kelas tertinggi.
Pada tahap ini, tujuan utamanya biasanya adalah memastikan lingkungan pengembangan berjalan, menguji kompatibilitas software, serta memahami kebutuhan resource aplikasi.
GPU dengan kapasitas memori lebih kecil dapat menjadi pilihan awal jika kebutuhan model memang mencukupi.
Namun, kamu sebaiknya melakukan pengukuran penggunaan VRAM terlebih dahulu sebelum meningkatkan ukuran model atau menjalankan eksperimen tambahan.
Cloud GPU untuk Fine-Tuning Model Bahasa
Proyek fine-tuning membutuhkan perencanaan resource berdasarkan ukuran model, precision, metode training, dan panjang konteks.
Misalnya, dua tim menggunakan model dasar yang sama, tetapi salah satu tim melakukan full fine-tuning sementara tim lainnya menggunakan LoRA.
Kebutuhan memorinya dapat berbeda karena jumlah parameter yang diperbarui dan optimizer state yang disimpan tidak sama.
Karena itu, jumlah parameter model saja tidak cukup untuk menentukan spesifikasi GPU.
Kamu perlu memeriksa kebutuhan metode training yang dipilih serta melakukan uji coba menggunakan dataset yang representatif.
Cloud GPU untuk AI Inference Produksi
Aplikasi produksi biasanya membutuhkan pengukuran performa yang berbeda dibandingkan lingkungan eksperimen.
Pada aplikasi chatbot, misalnya, developer perlu mengetahui berapa lama pengguna menunggu respons pertama dan berapa banyak permintaan yang dapat diproses secara bersamaan.
Sebuah GPU mungkin mampu menjalankan model dengan lancar untuk satu pengguna, tetapi mengalami peningkatan latensi ketika jumlah permintaan bertambah.
Karena itu, pemilihan GPU untuk inference produksi harus mempertimbangkan throughput, concurrency, target latensi, dan biaya per permintaan.
Jika model yang dibutuhkan sebenarnya tersedia melalui API eksternal, kamu juga dapat membandingkan biaya penyewaan GPU dengan biaya penggunaan API sebelum menentukan arsitektur.
Cloud GPU untuk Rendering dan Video Processing
Aplikasi rendering dan pemrosesan video mempunyai kebutuhan yang berbeda dari sebagian workload AI.
Selain kapasitas memori dan performa komputasi, pengguna perlu memeriksa dukungan encoder, decoder, driver grafis, dan software rendering yang digunakan.
Misalnya, sebuah aplikasi video membutuhkan proses transcoding secara berulang. GPU dengan dukungan hardware video encoder dapat memberikan manfaat yang berbeda dibandingkan GPU yang terutama dioptimalkan untuk komputasi numerik.
Karena itu, pemilihan GPU untuk multimedia sebaiknya menggunakan benchmark rendering atau pemrosesan video yang sesuai dengan aplikasi sebenarnya.
Cara Menghitung Biaya Cloud GPU
Cloud GPU sering dipilih karena pengguna dapat mengakses resource komputasi tanpa harus membeli perangkat fisik. Namun, fleksibilitas tersebut tetap perlu diimbangi dengan perencanaan biaya yang cermat.
Biaya Cloud GPU biasanya dipengaruhi jenis GPU, konfigurasi instance, durasi penggunaan, lokasi server, model pembayaran, serta resource tambahan yang digunakan.
1. Pahami Model Pembayaran yang Tersedia
Penyedia Cloud GPU dapat menawarkan beberapa model pembayaran berdasarkan karakteristik layanan.
On-demand memungkinkan pengguna menjalankan resource sesuai kebutuhan dengan tarif yang berlaku. Model ini sering dipertimbangkan untuk eksperimen atau workload yang penggunaannya berubah-ubah.
Reserved atau committed usage menawarkan mekanisme komitmen penggunaan dalam periode tertentu. Pendekatan tersebut dapat sesuai untuk workload stabil, tetapi pengguna perlu memahami persyaratan dan kewajiban pembayarannya.
Spot atau preemptible instance memanfaatkan kapasitas komputasi yang tersedia dengan tarif berbeda dari layanan on-demand. Namun, resource tersebut dapat dihentikan oleh penyedia ketika kapasitas dibutuhkan kembali.
Menurut dokumentasi Amazon EC2 Spot Instances, instance Spot dapat mengalami interupsi akibat kebutuhan kapasitas atau kondisi lain yang ditentukan penyedia.
Karena itu, penggunaan instance Spot lebih sesuai untuk pekerjaan yang dapat diulang atau dilanjutkan melalui checkpoint.
2. Hitung Biaya Berdasarkan Durasi Penggunaan
Untuk membuat estimasi awal, kamu dapat menggunakan rumus berikut:
Biaya komputasi = tarif per jam × total jam penggunaan
Sebagai contoh ilustratif, anggap sebuah layanan GPU memiliki tarif USD2 per jam dan digunakan selama 5 jam setiap hari selama 12 hari.
Dengan konfigurasi tersebut, pengguna membutuhkan 60 jam komputasi dan menghasilkan biaya dasar sebesar USD120.
Angka tersebut hanya merupakan ilustrasi perhitungan, bukan harga aktual dari penyedia tertentu.
Total tagihan dapat berbeda karena platform mungkin mengenakan biaya tambahan untuk CPU, RAM, storage, jaringan, dan komponen lainnya.
3. Masukkan Biaya Tambahan ke Perhitungan
Ketika menggunakan Cloud GPU, pengguna tidak selalu hanya membayar resource GPU.
Beberapa layanan menerapkan biaya terpisah untuk penyimpanan persisten, transfer data keluar, alamat IP, image tertentu, atau resource lain yang digunakan.
Dalam dokumentasi harga GPU Google Cloud, Google menjelaskan bahwa GPU yang dipasang pada konfigurasi VM tertentu dapat menambah biaya di luar harga mesin virtual.
Karena itu, estimasi biaya perlu mempertimbangkan struktur penagihan dari penyedia yang dipilih.
Kamu dapat menggunakan rumus berikut sebagai dasar perencanaan:
Total biaya = komputasi + penyimpanan + transfer data + layanan tambahan
4. Bandingkan Biaya Berdasarkan Pekerjaan yang Selesai
Tarif GPU yang lebih murah tidak selalu menghasilkan biaya operasional paling rendah.
Misalnya, GPU pertama mempunyai tarif per jam rendah, tetapi membutuhkan waktu lebih lama untuk menyelesaikan proses training. GPU kedua mungkin mempunyai tarif lebih tinggi, tetapi dapat menyelesaikan pekerjaan lebih cepat.
Untuk membandingkan keduanya, kamu perlu mengukur durasi pekerjaan menggunakan model, dataset, dan konfigurasi yang sama.
Dari hasil tersebut, hitung total biaya yang dibutuhkan untuk menyelesaikan satu pekerjaan.
Pendekatan ini lebih relevan dibandingkan memilih layanan hanya berdasarkan tarif per jam atau nama perangkat GPU.
Kelebihan dan Keterbatasan Cloud GPU
Cloud GPU menawarkan sejumlah manfaat bagi developer maupun organisasi yang membutuhkan resource komputasi dengan kapasitas tertentu.
Namun, pengguna tetap perlu memahami keterbatasan layanan agar keputusan infrastruktur sesuai dengan kebutuhan jangka pendek dan jangka panjang.
Kelebihan Cloud GPU
- Mengurangi kebutuhan investasi perangkat keras. Pengguna dapat mengakses GPU yang dibutuhkan tanpa harus membeli server atau workstation dengan spesifikasi tinggi.
- Memberikan fleksibilitas penggunaan resource. Beberapa penyedia memungkinkan pengguna memilih konfigurasi berbeda sesuai perubahan workload dan kapasitas yang tersedia.
- Mendukung eksperimen menggunakan berbagai GPU. Developer dapat membandingkan karakteristik GPU tertentu tanpa harus memiliki seluruh perangkat secara fisik.
- Mempermudah akses komputasi jarak jauh. Tim yang bekerja dari beberapa lokasi dapat menggunakan lingkungan komputasi yang sama melalui jaringan.
- Mendukung pemisahan lingkungan pengembangan. Resource cloud memungkinkan tim menyiapkan lingkungan eksperimen tanpa harus selalu menggunakan komputer kerja utama.
Keterbatasan Cloud GPU
- Biaya dapat meningkat ketika resource digunakan terus-menerus. Penggunaan GPU dengan tarif per jam perlu dievaluasi kembali apabila workload berjalan sepanjang bulan.
- Ketersediaan GPU tidak selalu sama di setiap region. Penyedia dapat menerapkan pembatasan kuota atau kapasitas untuk GPU tertentu.
- Transfer data dapat menambah waktu dan biaya. Dataset besar yang harus dipindahkan antarregion dapat memengaruhi total biaya dan durasi pekerjaan.
- Konfigurasi software memerlukan perhatian teknis. Pengguna perlu memastikan kompatibilitas driver, framework, runtime, serta library yang digunakan.
- Sebagian model layanan mempunyai risiko interupsi. Instance dengan kapasitas yang dapat direbut kembali memerlukan mekanisme checkpoint dan pemulihan pekerjaan.
Dengan memahami kedua sisi tersebut, pengguna dapat menentukan kapan Cloud GPU memberikan manfaat yang sebanding dengan biaya dan kompleksitas operasionalnya.
Cara Menguji Performa Cloud GPU Sebelum Digunakan
Spesifikasi hardware membantu pengguna menyaring pilihan awal, tetapi pengujian aktual diperlukan untuk memastikan kesesuaian GPU dengan workload.
Benchmark sebaiknya menggunakan aplikasi, model, dan konfigurasi yang merepresentasikan kebutuhan penggunaan sebenarnya.
1. Periksa GPU yang Tersedia
Jika menggunakan lingkungan dengan GPU NVIDIA dan driver yang sesuai, kamu dapat menjalankan perintah berikut melalui terminal.
|
1 |
nvidia-smi |
Perintah tersebut menampilkan informasi perangkat yang terdeteksi, driver, penggunaan memori, dan aktivitas GPU sesuai dukungan hardware serta konfigurasi sistem.
Melalui informasi tersebut, kamu dapat memeriksa apakah GPU tersedia dan apakah aplikasi sedang menggunakan resource perangkat.
Namun, tingkat GPU utilization yang tinggi tidak otomatis menunjukkan bahwa seluruh proses berjalan efisien.
Kamu tetap perlu membandingkannya dengan waktu penyelesaian pekerjaan dan target performa aplikasi.
2. Periksa GPU Menggunakan PyTorch
Jika PyTorch sudah terpasang dengan build yang kompatibel, kamu dapat menggunakan kode berikut untuk memeriksa akses CUDA.
|
1 2 3 4 5 6 |
import torch print("CUDA tersedia:", torch.cuda.is_available()) if torch.cuda.is_available(): print("GPU:", torch.cuda.get_device_name(0)) |
Kode tersebut membantu kamu memastikan apakah PyTorch dapat mengakses GPU melalui CUDA.
Jika hasilnya menunjukkan bahwa CUDA tidak tersedia, periksa kompatibilitas GPU, instalasi driver, serta versi PyTorch yang digunakan.
3. Ukur Penggunaan Memori GPU
Ketika aplikasi dijalankan menggunakan PyTorch, kamu dapat memantau puncak alokasi memori tensor.
Contohnya, panggil fungsi berikut setelah workload yang ingin diukur selesai dijalankan.
|
1 2 3 4 5 6 7 8 9 10 11 |
import torch if torch.cuda.is_available(): torch.cuda.synchronize() peak_memory = torch.cuda.max_memory_allocated() print( "Peak tensor memory:", round(peak_memory / (1024 ** 3), 2), "GiB" ) |
Fungsi torch.cuda.max_memory_allocated() menampilkan puncak alokasi memori tensor yang dikelola PyTorch sejak statistik terakhir direset atau sejak proses dimulai.
Namun, metrik tersebut tidak selalu menggambarkan seluruh penggunaan VRAM perangkat. Aplikasi lain, CUDA runtime, dan alokasi di luar tensor PyTorch dapat menggunakan memori tambahan.
Untuk memahami pembacaan statistik tersebut, kamu dapat mengacu pada dokumentasi CUDA memory PyTorch.
4. Ukur Waktu Training dan Kecepatan Inference
Benchmark training dapat dilakukan dengan mengukur durasi sejumlah training step atau waktu yang diperlukan untuk menyelesaikan satu epoch.
Sementara itu, aplikasi inference membutuhkan metrik yang sesuai dengan karakteristik model.
Perlu diperhatikan bahwa pekerjaan GPU dapat berjalan secara asynchronous terhadap CPU.
Karena itu, pengukuran menggunakan timer biasa perlu memperhitungkan sinkronisasi proses agar durasi yang tercatat tidak menyesatkan.
Dokumentasi PyTorch Benchmark menjelaskan berbagai pertimbangan pengukuran performa, termasuk sinkronisasi operasi CUDA.
5. Bandingkan Hasil dengan Kondisi yang Sama
Benchmark akan lebih bermanfaat jika seluruh kandidat GPU diuji menggunakan konfigurasi yang setara.
Misalnya, kamu ingin membandingkan dua layanan untuk inference model bahasa. Gunakan model, quantization, panjang input, jumlah output, dan tingkat concurrency yang sama.
Catat hasil pengujian dalam tabel agar perbandingan performa dan biaya lebih mudah dilakukan.
Lakukan beberapa kali pengujian untuk mengurangi pengaruh kondisi sesaat.
Hasil tersebut dapat membantu kamu mengetahui GPU mana yang mampu memenuhi kebutuhan performa dengan total biaya yang lebih masuk akal.
Tips Memilih Penyedia Cloud GPU
Setelah kebutuhan teknis diketahui, pengguna dapat mengevaluasi layanan berdasarkan ketersediaan resource, transparansi harga, kualitas dokumentasi, dan kemampuan operasional.
Beberapa pertimbangan berikut dapat digunakan sebelum memilih penyedia Cloud GPU.
Pastikan Spesifikasi dan Alokasi GPU Jelas
Periksa apakah layanan menggunakan GPU penuh, GPU virtual, atau pembagian resource melalui teknologi tertentu.
Kamu juga perlu mengetahui kapasitas VRAM aktual yang dialokasikan kepada instance.
Jika penyedia menggunakan GPU shared, periksa apakah terdapat pembatasan penggunaan komputasi atau ketentuan performa tambahan.
Periksa Ketersediaan Region dan Kuota
Jenis GPU tertentu mungkin hanya tersedia pada region atau zona tertentu.
Selain itu, platform cloud dapat menerapkan kuota yang membatasi jumlah GPU yang dapat digunakan oleh sebuah akun.
Pastikan kapasitas yang dibutuhkan tersedia sebelum merencanakan migrasi atau deployment dengan jadwal ketat.
Evaluasi Keamanan dan Privasi Data
Penggunaan Cloud GPU sering melibatkan pemrosesan dataset yang dapat mengandung informasi internal atau sensitif.
Karena itu, periksa pengaturan akses instance, enkripsi data, isolasi jaringan, mekanisme penghapusan file, serta lokasi pemrosesan data.
Jika organisasi memiliki persyaratan kepatuhan tertentu, pastikan kebijakan penyedia dapat memenuhi kebutuhan tersebut.
Periksa Dokumentasi dan Dukungan Teknis
Dokumentasi yang baik membantu pengguna menyiapkan driver, runtime, framework, dan lingkungan aplikasi dengan lebih terarah.
Selain itu, pengguna perlu memahami batas dukungan teknis yang diberikan penyedia.
Sebagian layanan mungkin membantu masalah infrastruktur, tetapi tidak menangani konfigurasi framework atau debugging aplikasi AI yang dikembangkan pelanggan.
Dengan mengetahui batas dukungan sejak awal, tim dapat memperkirakan pekerjaan operasional yang harus dikelola secara mandiri.
Kesimpulan
Cloud GPU menyediakan akses terhadap kemampuan komputasi GPU melalui infrastruktur cloud sehingga pengguna dapat menjalankan berbagai workload tanpa harus memiliki perangkat keras secara langsung.
Teknologi ini dapat digunakan untuk training deep learning, AI inference, fine-tuning model bahasa, rendering grafis, serta komputasi ilmiah. Namun, manfaatnya tetap bergantung pada kesesuaian hardware dengan aplikasi yang dijalankan.
Ketika memilih Cloud GPU, kamu perlu mempertimbangkan kapasitas VRAM, jenis GPU, kemampuan CPU, RAM, storage, konektivitas jaringan, serta model pembayaran layanan.
Pengujian performa menggunakan workload yang representatif juga membantu memastikan bahwa spesifikasi GPU benar-benar memenuhi kebutuhan aplikasi.
Dengan memahami aspek teknis dan ekonomis tersebut, kamu dapat menentukan apakah Cloud GPU merupakan pilihan yang tepat atau apakah pendekatan komputasi lain lebih sesuai dengan kebutuhan proyek.
FAQ Seputar Cloud GPU

Hazar Farras
Hi ! I'm a Technical Content Specialist in DomaiNesia. Passionate about challenges, technology enthusiast, and dedicated K-pop lover always exploring new horizons and trends