Cara Membuat Knowledge Base AI untuk Chatbot dan RAG
Oleh
Ratna Patria
Bayangkan kamu sedang membangun chatbot untuk membantu tim customer support sebuah layanan SaaS. Chatbot tersebut harus bisa menjawab pertanyaan tentang reset password, kebijakan refund, pengelolaan akun, sampai prosedur perubahan paket.
Tim kamu sebenarnya sudah memiliki semua informasi tersebut. Masalahnya, informasi itu tersebar di halaman FAQ, dokumen SOP, artikel panduan, dan riwayat tiket support.
Kamu kemudian memasukkan seluruh dokumen tersebut ke dalam sistem RAG. Model AI yang digunakan sudah cukup bagus, tetapi chatbot masih beberapa kali mengambil kebijakan lama atau memberikan jawaban yang tidak sesuai prosedur terbaru.
Masalah seperti ini menunjukkan bahwa kualitas chatbot tidak hanya bergantung pada model AI. Sistem juga membutuhkan knowledge base yang memiliki sumber data jelas, struktur dokumen yang konsisten, metadata yang lengkap, serta mekanisme retrieval yang sudah diuji.
Artikel ini akan membahas cara membuat knowledge base AI dengan pendekatan yang lebih praktis. Kita akan menggunakan satu studi kasus yang sama dari awal sampai akhir agar kamu dapat melihat perubahan dokumen mentah menjadi sumber informasi yang siap digunakan oleh chatbot atau sistem RAG.
Gambaran Alur Membuat Knowledge Base AI
Sebelum mulai, kamu perlu memahami posisi setiap proses di dalam pipeline.
Secara sederhana, knowledge base yang akan kita bangun mengikuti alur berikut.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 |
Dokumen Sumber ↓ Data Cleaning ↓ Metadata ↓ Chunking ↓ Embedding ↓ Vector Database ↓ Retrieval Test ↓ LLM ↓ Jawaban + Sumber |
Alur tersebut menunjukkan bahwa vector database bukan titik awal pembuatan knowledge base. Tim justru perlu memastikan kualitas dokumen sebelum memikirkan embedding dan retrieval.
Kita akan menggunakan contoh chatbot customer support agar setiap tahap memiliki input dan output yang jelas.
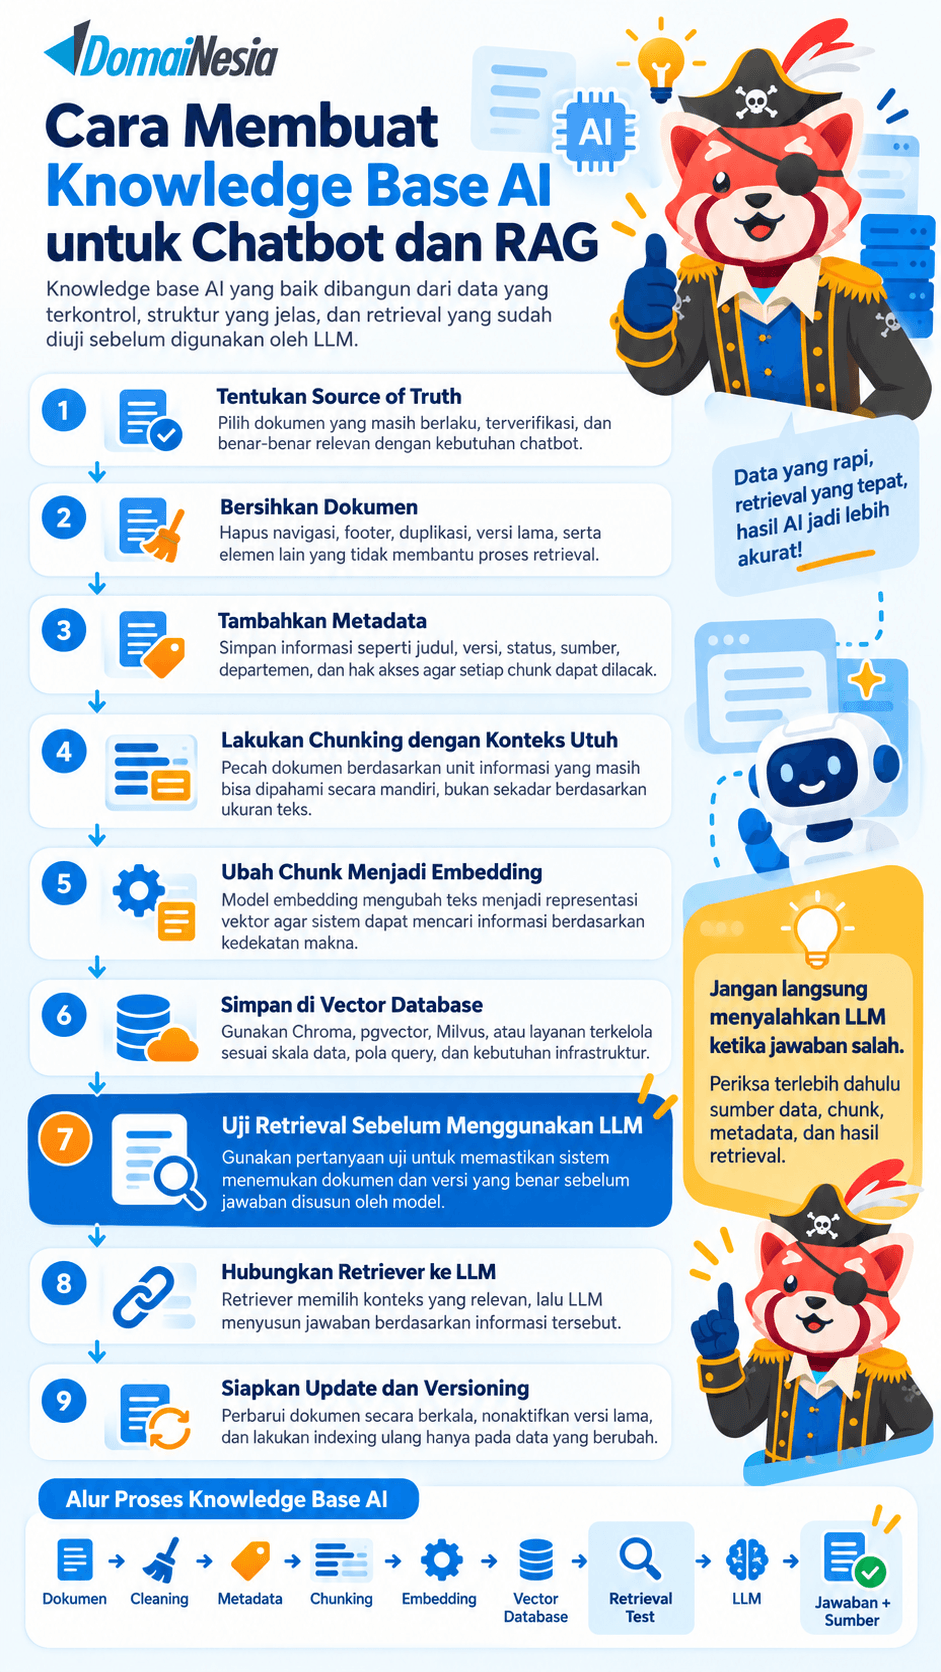
1. Kumpulkan Data dan Tentukan Source of Truth
Tim customer support dalam studi kasus kita memiliki lima sumber informasi berikut.
Langkah pertama dalam cara membuat knowledge base AI bukan memilih vector database. Kamu perlu menentukan informasi mana yang memang layak menjadi referensi sistem.
Dalam contoh tersebut, SOP Refund v3 menjadi source of truth untuk pertanyaan refund. Sistem tidak boleh mengambil SOP Refund v2 hanya karena dokumen tersebut memiliki kalimat yang lebih mirip dengan pertanyaan pengguna.
Prinsip yang sama berlaku ketika kamu mengelola harga, kebijakan keamanan, prosedur teknis, atau dokumentasi produk. Setiap informasi yang berpotensi berubah sebaiknya mempunyai sumber resmi dan versi yang jelas.
Kamu juga perlu berhati-hati ketika menggunakan tiket customer support sebagai sumber data. Riwayat percakapan dapat memberikan banyak contoh kasus nyata, tetapi jawaban agen pada masa lalu belum tentu selalu benar atau masih berlaku.
Karena itu, tim sebaiknya memverifikasi data tersebut sebelum memasukkannya ke knowledge base.
Tentukan Dokumen yang Benar-Benar Dibutuhkan
Kamu tidak perlu memasukkan semua dokumen yang dimiliki perusahaan.
Untuk chatbot customer support tadi, kita dapat memulai dengan tiga kelompok dokumen.
- FAQ membantu chatbot menjawab pertanyaan umum.
- SOP membantu chatbot memahami kebijakan resmi.
- Dokumentasi produk membantu chatbot menjelaskan langkah penggunaan layanan.
Dataset yang kecil tetapi terkontrol biasanya lebih mudah diuji dibandingkan kumpulan ribuan dokumen yang belum diketahui kualitasnya.
Setelah sumber data sudah jelas, kamu dapat mulai membersihkan dokumen tersebut.
2. Bersihkan Dokumen Sebelum Membuat Embedding
Misalnya, tim mengambil halaman dokumentasi tentang reset password dari website perusahaan.
Hasil ekstraksi awal terlihat seperti berikut.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 |
Home Product Pricing Documentation Contact Cara Reset Password Akun Untuk mengganti password, buka menu Account → Security. Pilih Change Password dan masukkan password baru. Related Articles Privacy Policy Terms of Service Copyright 2026 |
Manusia dapat memahami halaman tersebut karena tampilan website membantu membedakan menu dan konten utama.
Sistem retrieval melihat kondisi yang berbeda. Seluruh teks tersebut dapat dianggap sebagai bagian dari dokumen apabila pipeline tidak melakukan cleaning.
Kamu dapat membersihkan dokumen tersebut menjadi:
|
1 2 3 4 |
# Cara Reset Password Akun Untuk mengganti password, buka menu Account → Security. Pilih Change Password dan masukkan password baru. |
Perubahan tersebut terlihat sederhana, tetapi proses ini mengurangi teks yang tidak relevan ketika sistem melakukan retrieval.
Kamu sebaiknya memeriksa beberapa elemen berikut saat melakukan cleaning.
- Kamu perlu menghapus menu navigasi yang muncul pada setiap halaman.
- Kamu perlu menghapus footer dan copyright yang tidak membantu jawaban.
- Kamu perlu menghilangkan dokumen duplikat.
- Kamu perlu memisahkan dokumen yang sudah kedaluwarsa.
- Kamu perlu memperbaiki hasil ekstraksi tabel yang kehilangan struktur.
- Kamu perlu mempertahankan heading yang membantu menjelaskan konteks.
Sekarang bayangkan terdapat 500 halaman dokumentasi dan setiap halaman membawa 20 baris menu navigasi. Pipeline dapat menghasilkan banyak chunk yang berisi teks berulang apabila cleaning tidak dilakukan sejak awal.
Retriever kemudian harus mencari informasi yang relevan di antara data yang sebenarnya tidak dibutuhkan.
Karena itu, tahap cleaning sebaiknya dilakukan sebelum tim mulai memikirkan model embedding.
3. Tambahkan Metadata agar Dokumen Bisa Dilacak
Setelah dokumen sudah bersih, kamu perlu menambahkan informasi yang membantu sistem memahami asal dan status dokumen.
Mari menggunakan SOP Refund v3 sebagai contoh.
Konten utamanya dapat berbentuk seperti berikut.
|
1 2 3 4 5 6 7 8 |
# Kebijakan Refund Pelanggan dapat mengajukan refund maksimal tujuh hari setelah pembayaran. Refund hanya dapat dilakukan apabila layanan belum digunakan. Permintaan refund diajukan melalui dashboard pelanggan. |
Konten tersebut dapat disertai metadata seperti berikut.
|
1 2 3 4 5 6 7 8 9 10 |
{ "document_id": "refund-policy-v3", "title": "Kebijakan Refund", "section": "Syarat Refund", "version": "3.0", "department": "customer-support", "status": "active", "access": "public", "updated_at": "2026-09-20" } |
Metadata tersebut membuat sistem tidak hanya mengenali isi dokumen. Sistem juga mengetahui versi, status, pemilik, dan konteks dokumen.
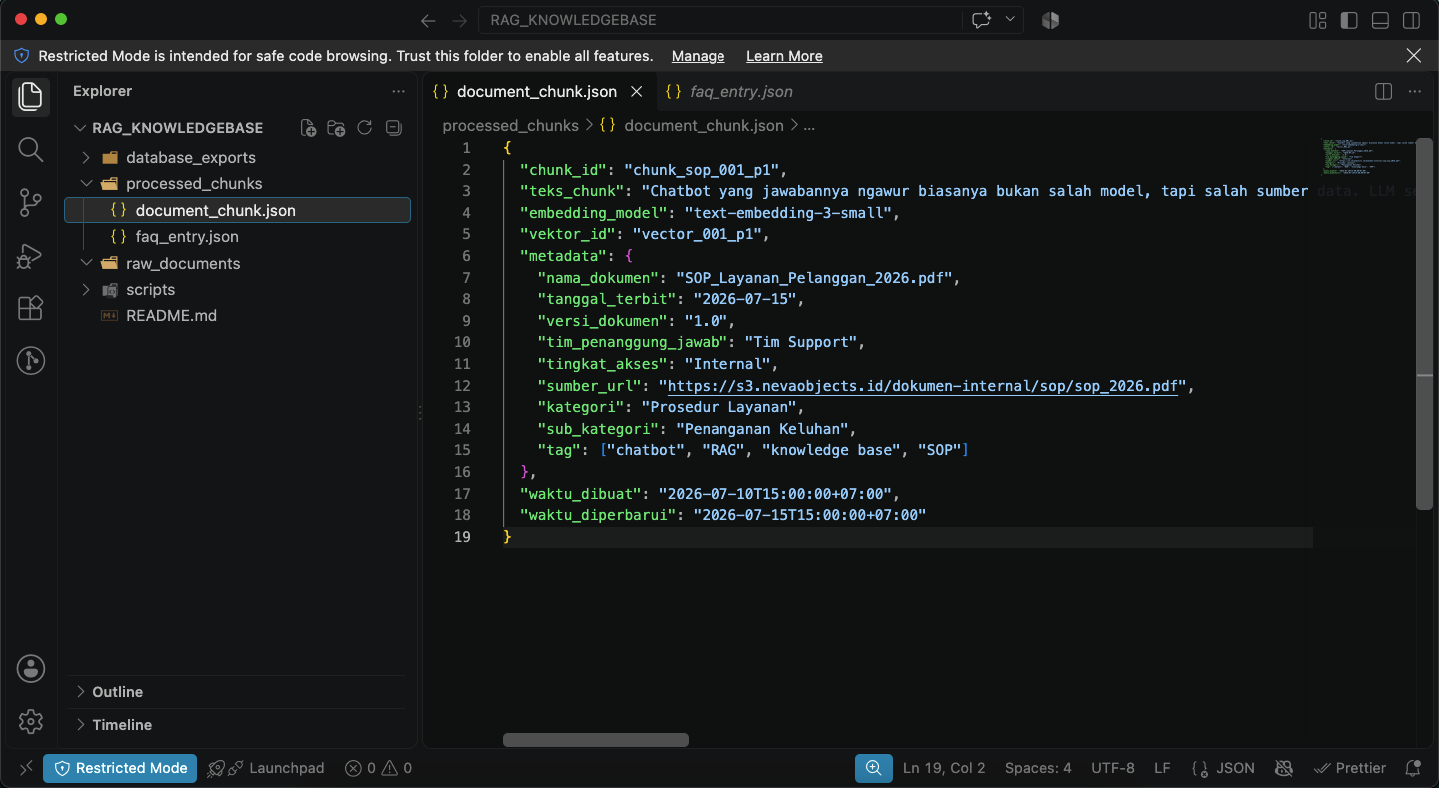
Misalnya, perusahaan kemudian merilis SOP Refund v4.
Pipeline dapat mengubah status dokumen sebelumnya menjadi:
|
1 2 |
refund-policy-v3 status = archived |
Sementara dokumen terbaru memiliki:
|
1 2 |
refund-policy-v4 status = active |
Retriever kemudian dapat menggunakan filter:
|
1 |
status = active |
Filter tersebut membantu mencegah dokumen lama masuk ke hasil pencarian meskipun secara semantik dokumen tersebut sangat mirip dengan pertanyaan pengguna.
Metadata juga dapat membantu ketika perusahaan memiliki informasi dengan tingkat akses berbeda.
Sebagai contoh, chatbot publik sebaiknya tidak mengambil dokumen internal hanya karena isi dokumen tersebut berkaitan dengan pertanyaan pengguna.
Kamu dapat menyimpan metadata seperti:
|
1 |
access = public |
atau:
|
1 |
access = internal |
Aplikasi kemudian dapat menerapkan filter sebelum melakukan retrieval.
Dengan pendekatan tersebut, metadata bukan sekadar informasi tambahan. Metadata menjadi bagian dari mekanisme kontrol knowledge base.
4. Pecah Dokumen Menjadi Chunk yang Tetap Memiliki Konteks
Setelah dokumen bersih dan memiliki metadata, kamu perlu menentukan cara memecah dokumen menjadi chunk.
Kesalahan yang umum terjadi pada tahap ini adalah menganggap chunk yang lebih kecil selalu menghasilkan pencarian yang lebih akurat.
Mari menggunakan dokumen refund tadi.
Dokumen asli memiliki informasi berikut.
|
1 2 3 4 5 6 7 8 |
# Kebijakan Refund Pelanggan dapat mengajukan refund maksimal tujuh hari setelah pembayaran. Refund hanya dapat dilakukan apabila layanan belum digunakan. Permintaan refund diajukan melalui dashboard pelanggan. |
Jika sistem memotong dokumen secara terlalu agresif, hasilnya dapat menjadi:
|
1 2 3 4 5 6 7 8 9 10 11 |
Chunk 1: Pelanggan dapat mengajukan refund. Chunk 2: Maksimal tujuh hari setelah pembayaran. Chunk 3: Layanan belum digunakan. Chunk 4: Melalui dashboard pelanggan. |
Setiap chunk tersebut memang memiliki ukuran kecil, tetapi beberapa potongan kehilangan konteks.
Chunk ketiga hanya mengatakan “layanan belum digunakan”. Retriever dapat menemukan kalimat tersebut, tetapi LLM belum tentu memahami hubungan kalimat itu dengan kebijakan refund.
Kamu dapat mempertahankan konteks menjadi:
|
1 2 3 4 5 6 7 8 9 |
Title: Kebijakan Refund Section: Syarat Refund Pelanggan dapat mengajukan refund maksimal tujuh hari setelah pembayaran. Refund hanya dapat dilakukan apabila layanan belum digunakan. Permintaan refund diajukan melalui dashboard pelanggan. |
Chunk tersebut memiliki satu unit informasi yang utuh.
Gunakan Struktur Dokumen sebagai Titik Awal
Kamu tidak harus langsung menentukan satu angka chunk size untuk seluruh knowledge base.
Jenis dokumen yang berbeda membutuhkan strategi yang berbeda.
Angka token tetap dapat digunakan sebagai batas teknis, tetapi struktur informasi sebaiknya menjadi pertimbangan utama.
Kamu juga dapat menggunakan overlap ketika informasi pada akhir satu chunk masih berhubungan dengan awal chunk berikutnya. Namun, overlap sebaiknya tidak digunakan secara berlebihan karena sistem akan menyimpan informasi duplikat lebih banyak.
Tujuan utama chunking bukan menghasilkan potongan sekecil mungkin. Kamu perlu menghasilkan unit informasi yang masih dapat dipahami ketika retriever menemukannya secara terpisah.
5. Ubah Chunk Menjadi Embedding
Sekarang knowledge base kita sudah memiliki data yang lebih terstruktur.
Pipeline sudah memiliki:
|
1 2 3 4 5 |
Dokumen bersih + Metadata + Chunk |
Tahap berikutnya mengubah setiap chunk menjadi embedding.
Embedding merepresentasikan isi teks dalam bentuk vektor sehingga sistem dapat membandingkan kedekatan makna antartext.
Misalnya, pengguna bertanya:
|
1 |
Saya lupa password akun. Bagaimana cara menggantinya? |
Sementara dokumentasi menggunakan kalimat:
|
1 |
Untuk mengganti password, buka menu Account > Security. |
Kedua teks tidak identik, tetapi maknanya berhubungan.
Model embedding membantu sistem menemukan hubungan semantik tersebut tanpa mengandalkan kecocokan kata secara persis.
Pipeline indexing dapat digambarkan seperti berikut.
|
1 2 3 4 5 6 7 |
Chunk ↓ Embedding Model ↓ Vector ↓ Vector Database |
Ketika pengguna mengirim pertanyaan, pipeline menjalankan proses serupa.
|
1 2 3 4 5 |
Pertanyaan Pengguna ↓ Embedding Model ↓ Query Vector |
Vector database kemudian membandingkan query vector dengan vector dari dokumen yang sebelumnya sudah disimpan.
Kamu dapat menggunakan layanan embedding berbasis API atau menjalankan model sendiri pada infrastruktur yang kamu kelola.
Layanan API biasanya membuat proses implementasi lebih sederhana karena tim tidak perlu menjalankan model embedding secara mandiri.
Pendekatan self-hosted memberikan kontrol infrastruktur yang lebih luas, tetapi tim perlu mengelola runtime, dependency, worker, monitoring, dan resource server.
Jika kamu ingin memahami kebutuhan server untuk workload AI secara lebih luas, artikel mengenai Cloud VPS untuk AI dan machine learning dapat memberikan konteks tambahan sebelum kamu menentukan arsitekturnya.
Pipeline RAG yang mulai menjalankan API, worker, vector database, atau model secara mandiri membutuhkan lingkungan server yang dapat dikonfigurasi sesuai workload. Kamu dapat mempertimbangkan Cloud VPS DomaiNesia ketika membutuhkan kontrol server yang lebih fleksibel untuk membangun lingkungan tersebut.
6. Simpan Embedding di Vector Database
Setelah embedding terbentuk, sistem membutuhkan tempat untuk menyimpan dan mencarinya.
Di sinilah vector database berperan.
Namun, kamu tidak perlu memilih database hanya berdasarkan nama yang paling sering muncul dalam tutorial AI.
Gunakan kebutuhan aplikasi sebagai titik awal.
Misalnya, aplikasi customer support kita sudah menyimpan akun dan data aplikasi menggunakan PostgreSQL.
Tim dapat mengevaluasi pgvector apabila ingin menambahkan kemampuan vector search tanpa langsung memperkenalkan sistem database baru.
Pilihan tersebut belum tentu menjadi solusi terbaik untuk semua aplikasi. Tim tetap perlu mempertimbangkan volume vector, pola query, metadata filtering, kebutuhan scaling, backup, latency, dan biaya operasional.
Jangan Memilih Database Sebelum Mengetahui Bebannya
Misalnya, knowledge base baru memiliki 2.000 chunk dan jumlah query masih rendah.
Tim mungkin belum membutuhkan arsitektur vector search yang kompleks.
Sebaliknya, sistem yang memiliki jutaan vector, banyak pengguna bersamaan, serta kebutuhan filtering yang kompleks memerlukan pengujian arsitektur yang lebih serius.
Kamu perlu menggunakan hasil pengukuran untuk menentukan kapan arsitektur perlu ditingkatkan.
7. Uji Retrieval Sebelum Menghubungkannya ke LLM
Tahap ini sering dilewati.
Tim biasanya langsung menghubungkan vector database ke LLM setelah proses embedding selesai. Ketika chatbot memberikan jawaban yang salah, tim kemudian menganggap model AI sebagai penyebab utama.
Padahal masalah tersebut dapat terjadi karena retriever mengambil dokumen yang salah.
Kita dapat menguji knowledge base tanpa melibatkan LLM terlebih dahulu.
Siapkan beberapa pertanyaan yang sudah memiliki jawaban dan sumber yang diketahui.
Hasil tersebut langsung memberikan informasi yang bisa ditindaklanjuti.
Pertanyaan ketiga gagal karena retriever mengambil FAQ lama.
Tim kemudian dapat memeriksa beberapa kemungkinan.
- Apakah FAQ lama masih memiliki status aktif?
- Apakah metadata filter sudah digunakan?
- Apakah chunk pada SOP terbaru terlalu besar?
- Apakah pertanyaan pengguna memiliki istilah yang berbeda dengan dokumen?
- Apakah hasil retrieval perlu melalui proses reranking?
Kamu sebaiknya memperbaiki masalah retrieval sebelum melakukan tuning terhadap prompt LLM.
Periksa Dokumen yang Ditemukan, Bukan Hanya Jawaban Akhir
Untuk setiap pertanyaan evaluasi, kamu dapat menampilkan beberapa hasil teratas.
Contohnya:
|
1 2 3 4 5 6 7 8 9 10 11 |
Query: Apakah layanan yang sudah digunakan bisa direfund? Result 1: Kebijakan Refund v3 Result 2: FAQ Refund Result 3: SOP Pembayaran |
Jika sumber yang benar sudah berada pada posisi pertama, pipeline retrieval memiliki sinyal yang cukup baik.
Jika dokumen yang relevan bahkan tidak masuk beberapa hasil teratas, kamu perlu kembali memeriksa data, chunking, embedding, atau metode pencariannya.
Bandingkan Beberapa Konfigurasi
Kamu juga dapat membandingkan konfigurasi retrieval.
Sebagai contoh, tim dapat menguji apakah mengambil tiga kandidat memberikan hasil yang lebih konsisten dibandingkan mengambil lima kandidat.
Angka tersebut hanya berfungsi sebagai konfigurasi eksperimen. Kamu tetap perlu menentukan nilai yang sesuai berdasarkan hasil evaluasi aplikasi.
Tahap pengujian ini membuat keputusan teknis lebih berbasis data dibandingkan hanya mengikuti konfigurasi dari tutorial lain.
🚀
Jalankan Infrastruktur RAG dengan Kontrol yang Lebih Fleksibel
Ketika aplikasi mulai menjalankan ingestion worker, API, vector database, scheduler pembaruan, serta service lain secara bersamaan, kamu dapat menempatkan workload tersebut pada lingkungan server yang dapat dikonfigurasi sesuai kebutuhan aplikasi.
8. Hubungkan Retriever ke LLM
Setelah retriever berhasil menemukan dokumen yang benar secara konsisten, kamu dapat menghubungkannya ke LLM.
Mari mengikuti satu pertanyaan dari awal sampai akhir.
Pengguna bertanya:
|
1 2 |
Apakah saya masih bisa meminta refund kalau layanan sudah digunakan? |
Sistem kemudian melakukan retrieval dan menemukan:
|
1 2 3 4 5 |
Source: Kebijakan Refund v3 Content: Refund hanya dapat dilakukan apabila layanan belum digunakan. |
Aplikasi dapat menyusun konteks untuk LLM seperti berikut.
|
1 2 3 4 5 6 7 8 9 10 11 12 |
Gunakan informasi pada konteks berikut untuk menjawab pertanyaan. Jangan membuat kebijakan baru apabila jawabannya tidak tersedia. KONTEKS: Refund hanya dapat dilakukan apabila layanan belum digunakan. SUMBER: Kebijakan Refund v3 PERTANYAAN: Apakah saya masih bisa meminta refund kalau layanan sudah digunakan? |
LLM kemudian dapat memberikan jawaban berdasarkan informasi yang ditemukan.
Contohnya:
|
1 2 |
Berdasarkan Kebijakan Refund v3, refund hanya dapat diajukan apabila layanan belum digunakan. |
Perhatikan bahwa LLM bukan komponen yang mencari kebijakan refund secara langsung.
Retriever memilih sumber yang relevan terlebih dahulu. LLM kemudian menyusun jawaban menggunakan konteks yang diberikan.
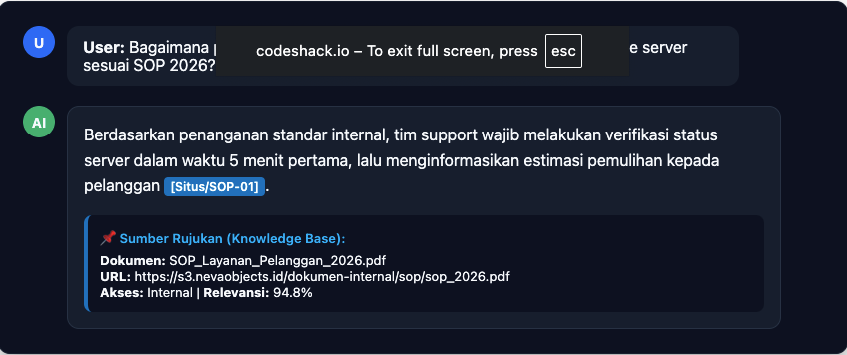
Pemisahan tersebut sangat penting ketika kamu melakukan debugging.
Jika sumber yang ditemukan salah, kamu perlu memeriksa retrieval pipeline.
Jika sumber sudah benar tetapi model masih menghasilkan jawaban yang tidak sesuai, kamu dapat memeriksa prompt, instruksi, context window, atau perilaku model.
Dengan cara ini, tim dapat mengetahui komponen mana yang sebenarnya membutuhkan perbaikan.
9. Siapkan Mekanisme Update dan Versioning
Knowledge base yang bekerja dengan baik pada hari pertama belum tentu tetap akurat beberapa bulan kemudian.
Kita dapat kembali menggunakan kebijakan refund sebagai contoh.
Perusahaan kemudian mengubah batas pengajuan refund dari tujuh hari menjadi empat belas hari.
Tim memperbarui SOP menjadi:
|
1 2 3 |
refund-policy-v4 version = 4.0 status = active |
Dokumen sebelumnya berubah menjadi:
|
1 2 3 |
refund-policy-v3 version = 3.0 status = archived |
Pipeline tidak harus membangun ulang seluruh knowledge base apabila hanya satu dokumen yang berubah.
Kamu dapat membuat proses incremental seperti berikut.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 |
Dokumen Berubah ↓ Deteksi Versi Baru ↓ Hapus/Nonaktifkan Chunk Lama ↓ Cleaning Dokumen Baru ↓ Chunking ↓ Embedding ↓ Upsert ke Vector Database |
Strategi tersebut membuat proses pembaruan lebih terkontrol.
Kamu juga perlu mencatat waktu indexing dan sumber asli dokumen agar tim dapat menelusuri masalah ketika chatbot memberikan jawaban yang sudah kedaluwarsa.
Pantau Pertanyaan yang Gagal Dijawab
Knowledge base tidak hanya perlu diperbarui berdasarkan perubahan dokumen.
Kamu juga dapat menggunakan percakapan pengguna sebagai sumber evaluasi.
Misalnya, dalam satu minggu terdapat banyak pertanyaan:
|
1 |
Bagaimana cara memindahkan kepemilikan akun? |
Namun, knowledge base tidak memiliki dokumentasi terkait proses tersebut.
Kegagalan retrieval seperti ini menunjukkan adanya knowledge gap.
Tim kemudian dapat membuat dokumentasi baru, memverifikasinya, dan memasukkannya ke pipeline.
Dengan demikian, knowledge base berkembang berdasarkan kebutuhan pengguna yang benar-benar terjadi.
Apakah Knowledge Base Sama dengan AI Agent?
Knowledge base dapat digunakan oleh chatbot biasa maupun AI agent.
Sistem RAG yang mengambil dokumen dan menjawab pertanyaan tidak otomatis menjadi AI agent.
Chatbot customer support pada contoh kita hanya menjalankan proses:
|
1 2 3 4 5 6 7 8 9 |
Pertanyaan ↓ Retrieval ↓ Context ↓ LLM ↓ Jawaban |
AI agent memiliki kemampuan yang lebih luas ketika sistem dapat menentukan tindakan berikutnya dan memilih tool berdasarkan kondisi tertentu.
Misalnya, pengguna mengatakan:
|
1 |
Saya ingin mengecek apakah refund saya sudah diproses. |
Knowledge base hanya dapat menjelaskan prosedur refund.
AI agent dapat memiliki tool tambahan yang memungkinkan sistem memeriksa status permintaan refund pada aplikasi perusahaan.
Alurnya dapat berubah menjadi:
|
1 2 3 4 5 6 7 8 9 10 11 |
Pertanyaan Pengguna ↓ Agent Menentukan Tindakan ↓ Pilih Tool Status Refund ↓ Ambil Data ↓ Evaluasi Hasil ↓ Berikan Jawaban |
Dalam arsitektur tersebut, knowledge base masih dapat digunakan untuk mencari kebijakan, sedangkan tool digunakan untuk mengambil data atau menjalankan tindakan.
Jika kamu ingin memahami mekanisme yang dapat digunakan untuk menghubungkan aplikasi AI dengan tool eksternal, pembahasan mengenai Model Context Protocol atau MCP dapat menjadi referensi lanjutan.
MCP, RAG, dan vector database memiliki fungsi yang berbeda. Ketiganya dapat digunakan bersama apabila arsitektur aplikasi memang membutuhkan kemampuan tersebut.
Checklist Knowledge Base Sebelum Digunakan
Sebelum knowledge base digunakan oleh pengguna sebenarnya, kamu dapat memeriksa beberapa hal berikut.
- Setiap dokumen memiliki sumber yang jelas.
- Dokumen lama sudah dinonaktifkan atau dihapus dari retrieval.
- Dokumen memiliki informasi versi ketika kontennya dapat berubah.
- Chunk masih dapat dipahami tanpa membaca seluruh dokumen.
- Metadata dapat digunakan untuk filtering.
- Dokumen sensitif memiliki aturan akses.
- Pertanyaan evaluasi menemukan sumber yang diharapkan.
- Tim sudah memeriksa beberapa hasil retrieval teratas.
- Sistem dapat melakukan indexing ulang terhadap dokumen yang berubah.
- Jawaban chatbot dapat ditelusuri kembali ke sumbernya.
- Kegagalan retrieval dapat dicatat dan dianalisis.
- Pipeline memiliki mekanisme monitoring serta backup yang sesuai.
Kamu tidak harus memenuhi seluruh kebutuhan enterprise sejak prototipe pertama. Namun, checklist tersebut dapat membantu menentukan bagian mana yang belum siap sebelum knowledge base menerima trafik pengguna sebenarnya.
Knowledge Base yang Baik Harus Bisa Diuji
Cara membuat knowledge base AI tidak dimulai dari memilih vector database yang paling populer. Proses tersebut dimulai ketika kamu menentukan informasi yang memang layak dipercaya oleh sistem.
Studi kasus chatbot customer support tadi menunjukkan bahwa setiap tahap saling memengaruhi.
Dokumen yang salah akan menghasilkan chunk yang salah. Chunk yang buruk akan menghasilkan retrieval yang sulit dikendalikan. Retrieval yang salah kemudian memberikan konteks yang salah kepada LLM.
Karena itu, kamu sebaiknya membangun knowledge base secara bertahap.
Mulailah dengan dataset kecil yang sudah diverifikasi. Bersihkan dokumen tersebut, tambahkan metadata, tentukan strategi chunking, buat embedding, lalu uji apakah retriever dapat menemukan sumber yang benar.
Kamu dapat menambah jumlah dokumen setelah pipeline dasar menghasilkan retrieval yang konsisten.
Pendekatan tersebut membuat pengembangan knowledge base lebih mudah dievaluasi karena tim mengetahui perubahan apa yang meningkatkan atau justru menurunkan kualitas pencarian.
Pada akhirnya, knowledge base yang berguna bukan knowledge base yang memiliki arsitektur paling rumit. Knowledge base yang berguna adalah sistem yang mampu menemukan informasi yang tepat, menggunakan versi yang benar, dan memberikan sumber yang dapat diperiksa ketika pengguna membutuhkan jawaban.

Ratna Patria
Hi! I have been writing about technology, AI, websites, and other digital things, turning complex topics into simple and enjoyable reads. I enjoy exploring new tools, ideas, and ways technology can make things easier. How about you?