Chunking pada RAG: Cara Memilih Ukuran, Overlap, dan Metadata
Oleh
Ratna Patria
Sistem Retrieval-Augmented Generation atau RAG tidak hanya bergantung pada kemampuan LLM dan vector database. Kualitas jawaban juga sangat dipengaruhi oleh cara sistem membagi dokumen menjadi potongan informasi sebelum proses retrieval berjalan.
Daftar Isi
Proses tersebut disebut chunking. Jika ukuran dan batas chunk tidak sesuai dengan karakter dokumen, sistem retrieval dapat mengambil konteks yang terlalu luas atau justru kehilangan informasi penting yang seharusnya dibaca sebagai satu kesatuan.
Artikel ini membahas cara memilih strategi chunking pada RAG, mulai dari jenis chunking, ukuran chunk, overlap, metadata, hingga metode evaluasi yang dapat kamu gunakan sebelum sistem masuk ke tahap produksi.
Mengapa Chunking pada RAG Memengaruhi Hasil Retrieval?
Pipeline RAG biasanya dimulai dengan memecah dokumen menjadi sejumlah chunk. Sistem kemudian mengubah setiap chunk menjadi embedding dan menyimpannya ke dalam vector database agar informasi tersebut dapat dicari kembali berdasarkan kemiripan makna.
Ketika pengguna mengirim pertanyaan, sistem retrieval mencari beberapa chunk yang dianggap paling relevan. Chunk tersebut kemudian diberikan kepada LLM sebagai konteks tambahan untuk menghasilkan jawaban.
Masalah dapat muncul ketika batas chunk memisahkan informasi yang sebenarnya masih saling berkaitan. Sistem mungkin menemukan potongan yang relevan secara semantik, tetapi potongan tersebut belum tentu membawa konteks yang cukup untuk menjawab pertanyaan pengguna.
Sebaliknya, chunk yang terlalu besar dapat membawa banyak informasi tambahan yang tidak dibutuhkan. Kondisi tersebut dapat menurunkan presisi retrieval sekaligus menambah jumlah token yang perlu diproses pada tahap berikutnya.
Karena itu, chunking tidak sebaiknya diperlakukan sebagai tahap preprocessing yang dilakukan sekali tanpa evaluasi. Strategi chunking perlu disesuaikan dengan struktur dokumen, karakter query, serta model yang digunakan oleh sistem RAG.
Jenis-Jenis Strategi Chunking pada RAG
Developer dapat menggunakan beberapa pendekatan untuk membagi dokumen. Setiap metode memiliki karakteristik berbeda sehingga tidak ada satu strategi yang selalu menghasilkan performa terbaik untuk semua dataset.
1. Fixed-Size Chunking
Fixed-size chunking membagi teks berdasarkan jumlah karakter atau token yang telah ditentukan. Metode ini relatif mudah diterapkan karena proses pemotongan tidak membutuhkan analisis struktur atau makna dokumen.
Kelemahannya, batas chunk dapat berada di tengah kalimat, paragraf, atau pembahasan tertentu. Risiko kehilangan konteks akan semakin besar apabila dokumen memiliki penjelasan panjang yang saling berkaitan.
2. Recursive Chunking
Recursive chunking mencoba membagi teks melalui pemisah alami secara bertahap. Sistem dapat memprioritaskan paragraf terlebih dahulu, kemudian kalimat, kata, atau karakter ketika ukuran potongan masih melebihi batas yang ditentukan.
Pendekatan ini sering digunakan sebagai baseline karena implementasinya relatif sederhana dan struktur dokumen masih dapat dipertahankan dengan cukup baik. Developer kemudian dapat menyesuaikan ukuran serta overlap berdasarkan hasil evaluasi retrieval.
3. Semantic Chunking
Semantic chunking menggunakan hubungan makna antarbagian teks untuk menentukan batas chunk. Sistem dapat membuat chunk baru ketika pembahasan mulai berpindah ke topik yang berbeda secara semantik.
Pendekatan ini dapat mempertahankan konteks dengan lebih baik pada jenis dokumen tertentu. Namun, prosesnya membutuhkan komputasi tambahan karena sistem perlu menganalisis representasi semantik sebelum menentukan batas setiap chunk.
4. Document-Based atau Hierarchical Chunking
Document-based chunking menggunakan struktur asli dokumen sebagai batas pemisah. Heading, subheading, halaman, bab, atau elemen struktural lainnya dapat menjadi acuan untuk membentuk chunk.
Metode ini cocok untuk dokumentasi teknis, manual produk, knowledge base, atau dokumen kebijakan yang sudah memiliki struktur konsisten. Hasilnya dapat kurang optimal apabila dokumen sumber tidak memiliki hierarki yang jelas.
5. LLM-Based Chunking
LLM-based chunking memanfaatkan model bahasa untuk menentukan batas informasi berdasarkan konteks. Pendekatan ini memberi ruang lebih besar kepada sistem untuk memahami hubungan antarbagian sebelum membentuk chunk.
Namun, proses tersebut menambah biaya, latensi, dan kompleksitas pipeline. Output chunking dari LLM juga tetap perlu dievaluasi karena penggunaan model yang lebih kompleks tidak otomatis menghasilkan retrieval yang lebih baik.
Konsep pemanfaatan model dan agent untuk mengambil keputusan secara lebih mandiri juga berkaitan dengan agentic AI, terutama ketika pipeline mulai melibatkan beberapa tahapan otomatis.
Berikut gambaran singkat karakter setiap pendekatan:
Untuk tahap awal, recursive chunking dapat digunakan sebagai baseline yang praktis pada banyak jenis dokumen teks. Developer tetap perlu membandingkan hasilnya dengan metode lain jika retrieval belum memberikan konteks yang diharapkan.
Cara Menentukan Ukuran Chunk yang Tepat
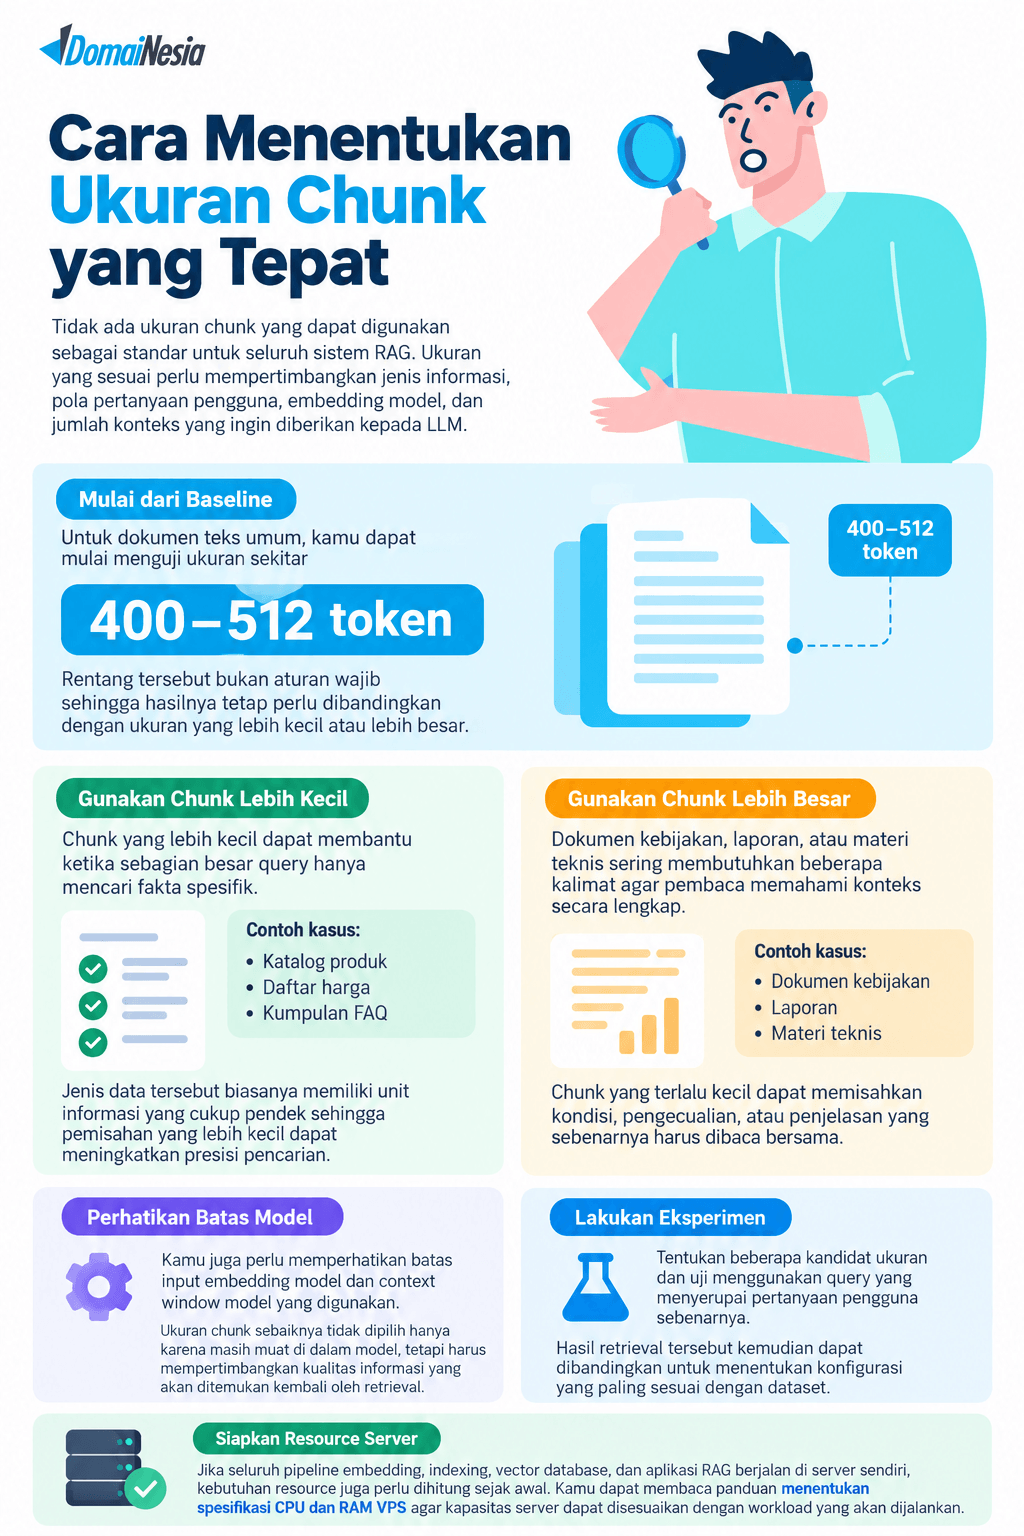
Tidak ada ukuran chunk yang dapat digunakan sebagai standar untuk seluruh sistem RAG. Ukuran yang sesuai perlu mempertimbangkan jenis informasi, pola pertanyaan pengguna, embedding model, dan jumlah konteks yang ingin diberikan kepada LLM.
Sebagai baseline eksperimen untuk dokumen teks umum, kamu dapat mulai menguji ukuran sekitar 400–512 token. Rentang tersebut bukan aturan wajib sehingga hasilnya tetap perlu dibandingkan dengan ukuran yang lebih kecil atau lebih besar.
Chunk yang lebih kecil dapat membantu ketika sebagian besar query hanya mencari fakta spesifik. Katalog produk, daftar harga, atau kumpulan FAQ biasanya memiliki unit informasi yang cukup pendek sehingga pemisahan yang lebih kecil dapat meningkatkan presisi pencarian.
Sebaliknya, dokumen kebijakan, laporan, atau materi teknis sering membutuhkan beberapa kalimat agar pembaca memahami konteks secara lengkap. Chunk yang terlalu kecil dapat memisahkan kondisi, pengecualian, atau penjelasan yang sebenarnya harus dibaca bersama.
Kamu juga perlu memperhatikan batas input embedding model dan context window model yang digunakan. Ukuran chunk sebaiknya tidak dipilih hanya karena masih muat di dalam model, tetapi harus mempertimbangkan kualitas informasi yang akan ditemukan kembali oleh retrieval.
Cara yang lebih aman adalah menentukan beberapa kandidat ukuran dan mengujinya menggunakan query yang menyerupai pertanyaan pengguna sebenarnya. Hasil retrieval tersebut kemudian dapat dibandingkan untuk menentukan konfigurasi yang paling sesuai dengan dataset.
Jika seluruh pipeline embedding, indexing, vector database, dan aplikasi RAG berjalan di server sendiri, kebutuhan resource juga perlu dihitung sejak awal. Kamu dapat membaca panduan menentukan spesifikasi CPU dan RAM VPS agar kapasitas server dapat disesuaikan dengan workload yang akan dijalankan.
Jika kamu membutuhkan environment server dengan resource yang lebih fleksibel untuk eksperimen maupun deployment RAG, kamu juga dapat mempertimbangkan Cloud VPS DomaiNesia sebagai infrastruktur untuk menjalankan komponen pipeline secara mandiri.
Cara Menentukan Chunk Overlap
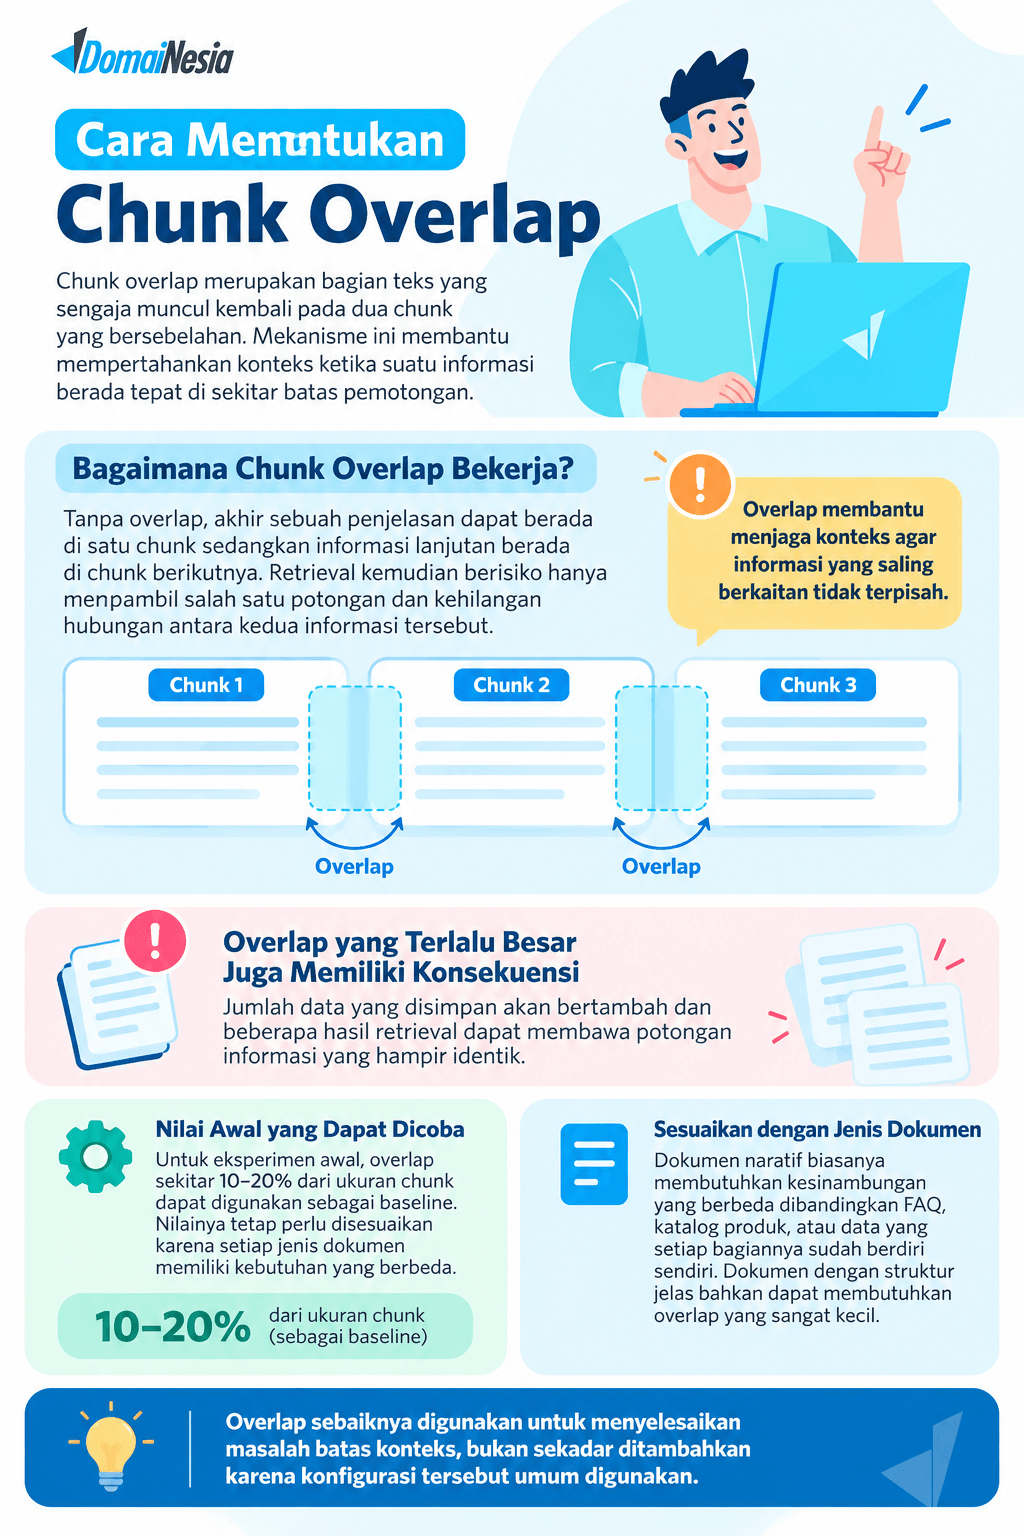
Chunk overlap merupakan bagian teks yang sengaja muncul kembali pada dua chunk yang bersebelahan. Mekanisme ini membantu mempertahankan konteks ketika suatu informasi berada tepat di sekitar batas pemotongan.
Tanpa overlap, akhir sebuah penjelasan dapat berada di satu chunk sedangkan informasi lanjutan berada di chunk berikutnya. Retrieval kemudian berisiko hanya mengambil salah satu potongan dan kehilangan hubungan antara kedua informasi tersebut.
Overlap yang terlalu besar juga memiliki konsekuensi. Jumlah data yang disimpan akan bertambah dan beberapa hasil retrieval dapat membawa potongan informasi yang hampir identik.
Untuk eksperimen awal, overlap sekitar 10–20% dari ukuran chunk dapat digunakan sebagai baseline. Nilainya tetap perlu disesuaikan karena dokumen naratif biasanya membutuhkan kesinambungan yang berbeda dibandingkan FAQ, katalog produk, atau data yang setiap bagiannya sudah berdiri sendiri.
Dokumen yang memiliki struktur jelas bahkan dapat membutuhkan overlap yang sangat kecil. Karena itu, overlap sebaiknya digunakan untuk menyelesaikan masalah batas konteks, bukan sekadar ditambahkan karena konfigurasi tersebut umum digunakan.
Menggunakan Metadata untuk Mempertahankan Konteks Chunk
Setelah dokumen dipecah, setiap chunk akan kehilangan sebagian hubungan dengan dokumen sumbernya. Metadata membantu sistem mempertahankan konteks tersebut tanpa harus memasukkan seluruh isi dokumen ke dalam setiap chunk.
Metadata yang tepat juga dapat digunakan sebagai filter sebelum atau sesudah proses pencarian semantik. Sistem dapat membatasi retrieval berdasarkan sumber, kategori, tanggal, versi, atau hak akses tertentu.
Beberapa metadata yang dapat disimpan bersama setiap chunk antara lain:
- Judul dan sumber dokumen. Informasi ini membantu sistem melacak asal data serta memudahkan proses audit.
- Heading atau nama bagian. Metadata ini menjelaskan posisi chunk dalam struktur dokumen yang lebih besar.
- Tanggal dan versi. Informasi versi membantu sistem menghindari penggunaan dokumen lama ketika versi baru sudah tersedia.
- Kategori atau tipe dokumen. Metadata kategori dapat mempersempit ruang pencarian sebelum semantic retrieval berjalan.
- Hak akses. Informasi izin dapat digunakan untuk memastikan pengguna hanya memperoleh konteks yang memang boleh mereka akses.
Metadata tidak otomatis meningkatkan kualitas embedding. Namun, metadata dapat membuat proses retrieval lebih terkontrol karena sistem mempunyai informasi tambahan untuk memfilter dan menilai chunk yang akan digunakan.
⚙️
Butuh Resource Lebih Fleksibel untuk Pipeline RAG?
Pipeline RAG dapat melibatkan proses indexing, vector database, API, serta berbagai service tambahan yang membutuhkan resource berbeda. VPS memberikan ruang konfigurasi yang lebih fleksibel ketika kamu ingin mengelola stack tersebut secara mandiri.
Cara Menguji Kualitas Chunking Sebelum Produksi
Strategi chunking sebaiknya tidak dinilai hanya berdasarkan ukuran atau metode yang terlihat paling canggih. Evaluasi perlu menggunakan pertanyaan yang menyerupai query pengguna sebenarnya agar hasil pengujian mendekati kondisi produksi.
Kamu dapat membuat sekumpulan query dan menentukan chunk atau informasi yang seharusnya muncul untuk setiap pertanyaan. Sistem kemudian menjalankan retrieval menggunakan beberapa konfigurasi chunking agar hasilnya dapat dibandingkan secara objektif.
Beberapa metrik yang dapat digunakan meliputi recall@k, precision, serta kualitas jawaban akhir. Recall membantu melihat apakah informasi yang dibutuhkan berhasil masuk ke dalam hasil retrieval, sedangkan precision menunjukkan seberapa banyak hasil yang benar-benar relevan.
Kualitas jawaban akhir juga penting karena retrieval yang baik belum tentu menghasilkan jawaban optimal apabila konteks disusun dengan buruk. Evaluasi sebaiknya melihat pipeline secara menyeluruh, mulai dari dokumen sumber sampai respons yang diberikan kepada pengguna.
Jika proses evaluasi atau pengambilan data nantinya melibatkan AI yang terhubung dengan aplikasi dan sistem eksternal, kamu dapat mempelajari apa itu MCP untuk memahami mekanisme integrasi tersebut.
Kesalahan yang Sering Terjadi Saat Menentukan Chunking
Kesalahan pertama adalah menggunakan konfigurasi yang sama untuk seluruh jenis dokumen. Artikel, dokumentasi API, transkrip percakapan, FAQ, dan katalog produk memiliki karakter informasi yang berbeda sehingga belum tentu cocok menggunakan ukuran maupun strategi yang sama.
Kesalahan berikutnya adalah memilih ukuran chunk berdasarkan rekomendasi umum tanpa menguji query pengguna. Angka yang bekerja baik pada satu dataset dapat menghasilkan retrieval berbeda ketika embedding model, bahasa, struktur dokumen, atau pola pertanyaannya berubah.
Developer juga sering menambahkan overlap terlalu besar dengan anggapan bahwa semakin banyak konteks akan selalu meningkatkan akurasi. Konfigurasi tersebut justru dapat menghasilkan banyak chunk serupa dan meningkatkan kebutuhan penyimpanan maupun pemrosesan.
Kesalahan lain adalah mengabaikan metadata sejak tahap awal. Ketika jumlah dokumen terus bertambah, metadata menjadi semakin penting untuk filtering, versioning, attribution, dan penerapan hak akses.
Karena itu, proses chunking sebaiknya diperlakukan sebagai bagian dari desain retrieval yang perlu diuji dan dievaluasi secara berkala.
Chunking yang Tepat Membuat Retrieval Lebih Terarah
Chunking pada RAG menentukan bentuk informasi yang nantinya tersedia bagi sistem retrieval. Strategi yang tepat membantu sistem mengambil konteks yang cukup lengkap tanpa membawa terlalu banyak informasi yang tidak relevan.
Kamu dapat memulai dengan metode yang relatif sederhana, kemudian membandingkan beberapa ukuran chunk dan overlap menggunakan query yang realistis. Metadata juga perlu dirancang sejak awal agar setiap chunk tetap memiliki informasi mengenai sumber, struktur, versi, dan hak akses.
Konfigurasi terbaik tidak harus menjadi konfigurasi yang paling kompleks. Strategi chunking yang paling berguna adalah strategi yang secara konsisten membantu sistem menemukan informasi yang tepat untuk karakter dokumen dan kebutuhan pengguna yang sebenarnya.

Ratna Patria
Hi! I have been writing about technology, AI, websites, and other digital things, turning complex topics into simple and enjoyable reads. I enjoy exploring new tools, ideas, and ways technology can make things easier. How about you?