Prompt Caching pada LLM: Cara Kerja, Manfaat, dan Best Practice
Oleh
Hiqbal Fauzi
Hai DomaiNesians! Aplikasi berbasis Large Language Model atau LLM sering mengirim sebagian input yang sama secara berulang. System instruction, dokumentasi produk, contoh respons, definisi tool, hingga context panjang dapat muncul kembali dalam puluhan atau bahkan ribuan request.
Pemrosesan input yang sama secara berulang dapat meningkatkan penggunaan token dan waktu pemrosesan. Salah satu mekanisme yang dapat membantu mengoptimalkan proses tersebut adalah Prompt Caching.
Prompt Caching memungkinkan provider AI menggunakan kembali bagian prompt atau context yang sebelumnya sudah diproses. Mekanisme ini dapat menekan biaya pemrosesan input dan mengurangi latency pada kondisi tertentu, sementara model tetap menghasilkan respons baru berdasarkan request yang diterima.
Artikel ini akan membahas apa itu Prompt Caching pada LLM, cara kerjanya, jenis context yang cocok di-cache, perbedaannya dengan memory, hingga praktik implementasinya. Jika kamu masih mempelajari fondasi teknologi AI, kamu juga dapat memahami machine learning terlebih dahulu sebelum masuk ke optimasi aplikasi LLM.
Apa Itu Prompt Caching pada LLM?
Prompt Caching adalah mekanisme yang memungkinkan sebagian input atau prefix prompt yang sudah diproses digunakan kembali ketika request berikutnya memiliki bagian awal yang sama atau memenuhi mekanisme caching provider.
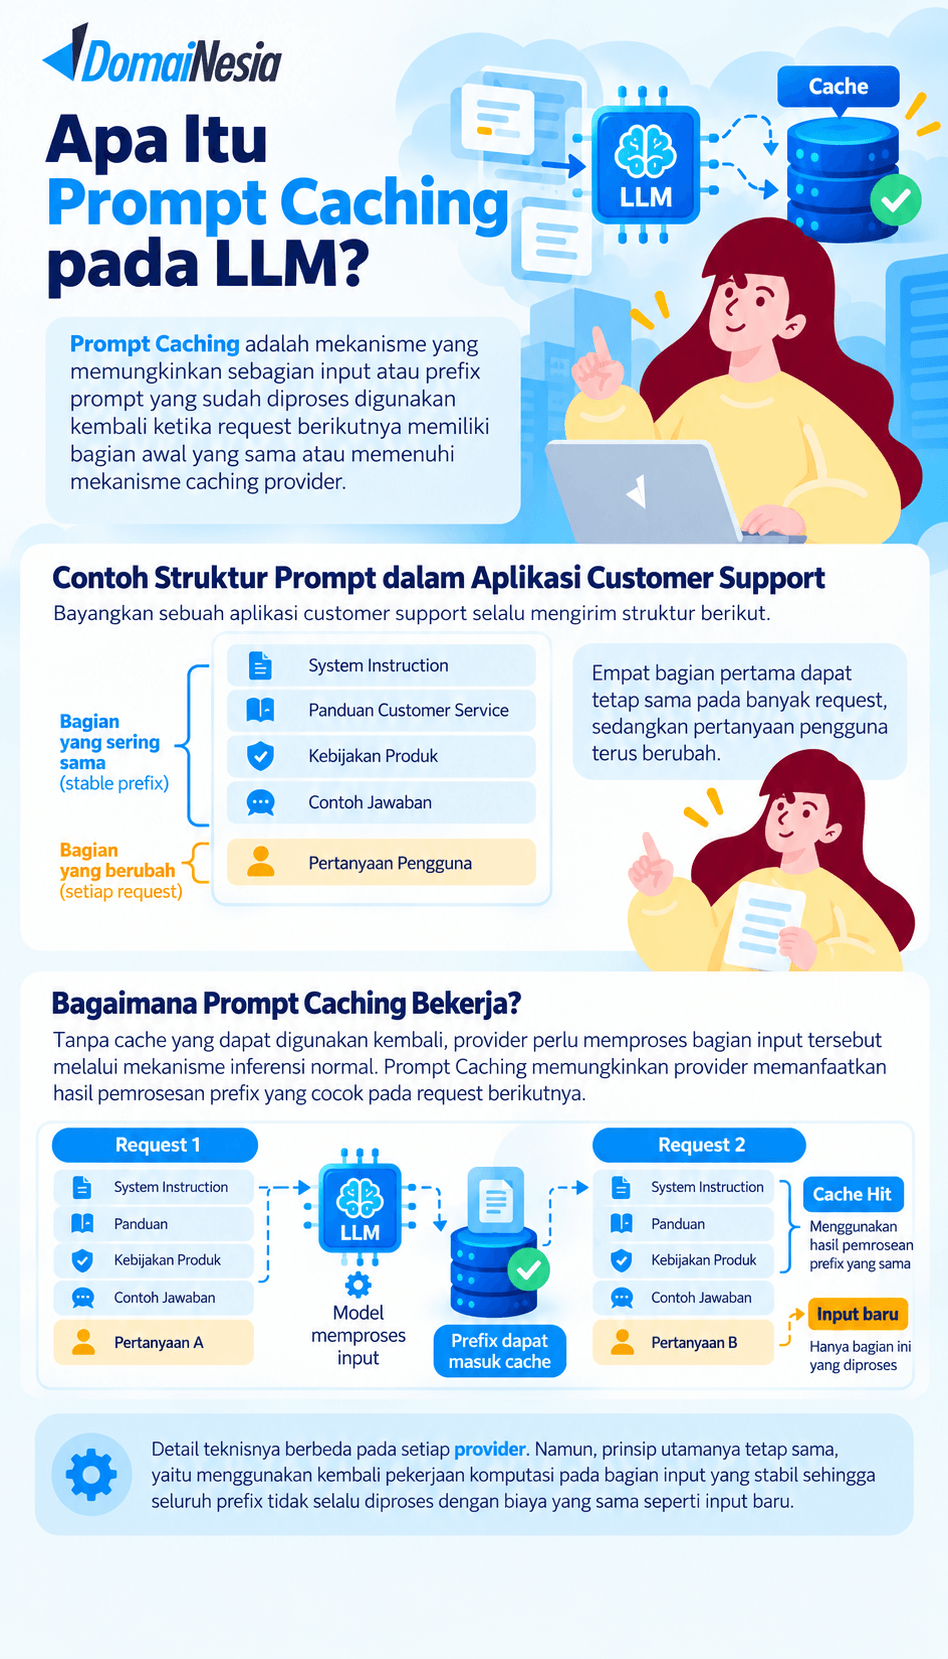
Bayangkan sebuah aplikasi customer support selalu mengirim struktur berikut.
|
1 2 3 4 5 6 7 8 9 |
System Instruction + Panduan Customer Service + Kebijakan Produk + Contoh Jawaban + Pertanyaan Pengguna |
Empat bagian pertama dapat tetap sama pada banyak request, sedangkan pertanyaan pengguna terus berubah.
Tanpa cache yang dapat digunakan kembali, provider perlu memproses bagian input tersebut melalui mekanisme inferensi normal. Prompt Caching memungkinkan provider memanfaatkan hasil pemrosesan prefix yang cocok pada request berikutnya.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 |
Request 1 [System Instruction] [Panduan] [Contoh] [Pertanyaan A] ↓ Model memproses input ↓ Prefix dapat masuk cache Request 2 [System Instruction] ─┐ [Panduan] ──┼─ Cache Hit [Contoh] ──┘ [Pertanyaan B] → Input baru |
Detail teknisnya berbeda pada setiap provider. Namun, prinsip utamanya tetap sama, yaitu menggunakan kembali pekerjaan komputasi pada bagian input yang stabil sehingga seluruh prefix tidak selalu diproses dengan biaya yang sama seperti input baru.
Mengapa Prompt Caching Dibutuhkan?
Aplikasi LLM modern dapat membawa context yang sangat besar. Context tersebut tidak hanya berisi pertanyaan pengguna, tetapi juga system instruction, riwayat percakapan, few-shot example, dokumen, knowledge base, dan definisi tool.
Semakin besar input yang dikirim kepada model, semakin banyak token yang harus diproses. Kondisi tersebut menjadi kurang efisien ketika sebagian besar token sebenarnya sama pada banyak request.
Sebagai contoh, sebuah coding assistant dapat membawa struktur seperti berikut.
|
1 2 3 4 |
System prompt: 3.000 token Coding guideline: 8.000 token Dokumentasi project: 15.000 token Pertanyaan developer: 300 token |
Jika system prompt, coding guideline, dan dokumentasi project tidak berubah, sebagian besar input sebenarnya merupakan context berulang. Bagian tersebut berpotensi memperoleh manfaat dari Prompt Caching ketika provider dan model yang digunakan mendukungnya.
Caching juga bukan satu-satunya faktor yang menentukan performa aplikasi. Developer tetap perlu memperhatikan jaringan, backend, model, dan strategi lain untuk mengurangi latency pada transfer data API.
Bagaimana Cara Kerja Prompt Caching?
Implementasi Prompt Caching dapat berbeda berdasarkan provider. Namun, alur konseptualnya dapat dijelaskan melalui beberapa tahapan berikut.
1. Developer Mengirim Seluruh Context
Request awal berisi context yang diperlukan model untuk menyelesaikan tugas.
|
1 2 3 4 5 |
Stable Context + Dynamic Input ↓ LLM API |
Stable context merupakan bagian yang berpotensi digunakan kembali. Dynamic input merupakan informasi yang berubah pada setiap request, seperti pertanyaan pengguna, hasil database terbaru, atau state aplikasi.
2. Provider Memproses Input
Provider memproses request dan menentukan bagian input yang memenuhi mekanisme caching. Pada implementasi tertentu, provider dapat menyimpan state atau representasi internal dari prefix tersebut agar dapat digunakan kembali.
Request pertama belum tentu mendapatkan keuntungan dari cache karena provider mungkin belum memiliki entry yang cocok. Keuntungan biasanya muncul ketika request berikutnya menggunakan prefix yang masih memenuhi syarat reuse.
3. Request Berikutnya Memiliki Prefix yang Sama
Provider kemudian mencoba mencari cache yang sesuai dengan bagian awal request berikutnya.
|
1 2 3 4 5 6 7 8 9 |
Stable Prefix ↓ Prefix Cocok ↓ Cache Hit + Input Baru ↓ LLM |
Jika prefix memenuhi aturan provider, request mendapatkan cache hit. Jika cache tidak tersedia atau bagian yang diperlukan berubah, request dapat mengalami cache miss.
4. Bagian yang Sama Digunakan Kembali
Provider dapat menggunakan kembali hasil pemrosesan bagian prefix yang cocok. Token setelah prefix tersebut tetap perlu diproses sebagai input baru.
Mekanisme ini membuat Prompt Caching sangat berguna pada aplikasi yang memiliki context panjang dan konsisten. Manfaat aktual tetap bergantung pada provider, model, panjang prompt, dan frekuensi reuse.
5. Model Tetap Menghasilkan Respons Baru
Prompt Caching tidak berarti provider menyimpan jawaban lalu mengirimkannya kembali kepada pengguna. Model tetap melakukan proses generation untuk menghasilkan respons baru.
Oleh karena itu, Prompt Caching berbeda dengan response caching yang biasa ditemukan pada aplikasi web.
Prompt Caching dan Response Caching Berbeda
Prompt Caching menyimpan atau menggunakan kembali pekerjaan pada bagian input, sedangkan response caching menggunakan kembali hasil akhir suatu request.
Misalnya, dua pengguna memakai system instruction yang sama tetapi mengajukan pertanyaan berbeda. Prompt Caching dapat membantu menggunakan kembali pemrosesan instruction tersebut, sedangkan model tetap menghasilkan jawaban baru untuk setiap pertanyaan.
Response caching memiliki tujuan berbeda karena aplikasi dapat langsung mengembalikan jawaban sebelumnya ketika cache key sesuai. Developer perlu menentukan mekanisme mana yang sesuai berdasarkan karakteristik request.
Prompt Caching vs AI Memory
Prompt Caching juga berbeda dengan memory pada aplikasi AI. Caching berfokus pada efisiensi pemrosesan input, sedangkan memory digunakan untuk menjaga informasi agar dapat dimanfaatkan kembali pada interaksi berikutnya.
Prompt Caching tidak membuat model secara otomatis mengingat pengguna. Aplikasi tetap membutuhkan database, state, memory store, atau sistem penyimpanan lain ketika informasi harus tersedia lintas sesi.
Prompt Caching Tidak Memperbesar Context Window
Token yang berhasil menggunakan cache tetap menjadi bagian dari context yang digunakan model. Prompt Caching mengubah cara provider memproses bagian input tersebut, bukan memperbesar kapasitas context window.
Sebagai contoh, aplikasi dapat menggunakan context seperti berikut.
|
1 2 3 |
80.000 token cached context + 10.000 token input baru |
Model secara konseptual tetap bekerja dengan keseluruhan informasi tersebut. Karena itu, developer tidak boleh menggunakan Prompt Caching sebagai alasan untuk memasukkan sebanyak mungkin informasi ke dalam prompt.
Developer tetap perlu memilih context yang relevan dan membuang informasi yang tidak diperlukan. Prompt Caching sebaiknya melengkapi context optimization, bukan menggantikannya.
Bagian Prompt yang Cocok untuk Caching
Prompt Caching memberikan manfaat terbesar ketika aplikasi memiliki bagian input yang cukup panjang, stabil, dan sering digunakan kembali. Beberapa jenis context berikut biasanya menjadi kandidat yang relevan.
1. System Instruction
System instruction dapat berisi aturan mengenai role, tone, format, batasan, maupun workflow aplikasi. Bagian tersebut dapat menjadi kandidat caching ketika isinya tetap konsisten pada banyak request.
Pada sistem yang mengandalkan prefix matching, developer juga dapat menempatkan instruction stabil sebelum informasi yang sering berubah. Struktur tersebut meningkatkan peluang prefix yang sama dapat digunakan kembali.
2. Few-Shot Example
Aplikasi dapat menggunakan beberapa contoh input dan output untuk menunjukkan format respons yang diharapkan.
|
1 2 3 4 5 6 7 8 9 10 11 |
Example 1 Input: ... Output: ... Example 2 Input: ... Output: ... Example 3 Input: ... Output: ... |
Jika kumpulan contoh tersebut jarang berubah, bagian ini dapat dimasukkan ke dalam stable context. Developer tetap perlu memastikan bahwa setiap contoh memang membantu kualitas output.
3. Dokumentasi Panjang
Aplikasi terkadang menjalankan banyak pertanyaan terhadap dokumen yang sama. Dokumen tersebut dapat menjadi kandidat caching karena pertanyaan berubah, sementara context utamanya tetap konsisten.
Use case ini dapat ditemukan pada assistant dokumentasi, analisis kontrak, technical manual, maupun aplikasi knowledge assistant.
4. Definisi Tool
AI Agent dapat memiliki puluhan definisi function atau tool dengan schema yang cukup panjang. Jika daftar dan definisinya tetap sama, bagian tersebut dapat berpotensi memanfaatkan Prompt Caching.
Developer yang sedang membangun aplikasi dengan tool eksternal juga dapat mempelajari apa itu MCP untuk memahami salah satu pendekatan yang digunakan aplikasi AI dalam berkomunikasi dengan tool dan sumber data eksternal.
5. Coding Guideline
Coding assistant dapat membawa style guide, aturan repository, convention, dan dokumentasi project. Informasi tersebut biasanya lebih stabil dibanding file atau error yang sedang diperiksa.
Developer dapat memisahkan bagian stabil tersebut dari current file, log, atau pertanyaan yang berubah pada setiap request.
6. Riwayat Percakapan yang Stabil
Pada percakapan multi-turn, bagian awal conversation history dapat tetap sama ketika pesan baru ditambahkan. Provider tertentu dapat memanfaatkan pola prefix tersebut selama struktur request masih memenuhi mekanisme caching yang digunakan.
Developer sebaiknya menghindari penulisan ulang bagian awal percakapan tanpa kebutuhan karena perubahan prefix dapat mengurangi cache reuse.
Bagian Prompt yang Kurang Cocok untuk Caching
Tidak semua informasi perlu dimasukkan ke stable prefix. Data yang berubah pada hampir setiap request justru dapat menurunkan peluang cache hit jika ditempatkan terlalu awal.
Contohnya meliputi:
- pertanyaan pengguna yang selalu berubah;
- timestamp setiap request;
- random ID atau request ID;
- data database real-time;
- harga atau ketersediaan stok;
- state sesi yang terus berubah;
- informasi pengguna yang berbeda antar-request.
Developer sebaiknya menempatkan informasi dinamis setelah bagian yang stabil selama struktur API dan provider memungkinkan pendekatan tersebut.
Sedang membangun backend untuk aplikasi berbasis LLM? Kamu dapat menggunakan Cloud VPS DomaiNesia untuk menjalankan backend API, database, worker, container, maupun service integrasi yang membutuhkan kontrol server lebih fleksibel. Prompt Caching tetap dikonfigurasi melalui provider AI yang digunakan, sedangkan VPS berfungsi sebagai infrastruktur aplikasi kamu.
Mengapa Urutan Prompt Memengaruhi Cache?
Prefix caching bergantung pada bagian awal request yang dapat digunakan kembali. Penempatan informasi dinamis terlalu awal dapat menyebabkan perubahan prefix meskipun sebagian besar context berikutnya tetap sama.
Struktur berikut cenderung kurang ideal.
|
1 2 3 4 5 6 |
User ID Dinamis Timestamp Pertanyaan Pengguna System Instruction Panjang Dokumentasi Tool Definition |
User ID, timestamp, dan pertanyaan terus berubah pada setiap request. Perubahan tersebut dapat mengurangi kesempatan bagian setelahnya memanfaatkan prefix yang sama.
Struktur yang lebih ramah cache dapat berupa:
|
1 2 3 4 5 6 |
System Instruction Dokumentasi Statis Few-Shot Example Tool Definition Data Dinamis Pertanyaan Pengguna |
Prinsip tersebut juga muncul dalam dokumentasi sejumlah provider. Developer tetap perlu mengikuti mekanisme provider karena aturan breakpoint dan pencocokan prefix tidak selalu identik.
Prompt Caching pada OpenAI, Claude, dan Gemini
Beberapa provider AI memiliki mekanisme caching untuk input yang berulang. Nama fitur, API, lifecycle, minimum token, dan aturan pencocokannya dapat berbeda.
Karena fitur LLM berkembang cepat, developer sebaiknya menggunakan bagian ini sebagai gambaran konsep. Dokumentasi resmi provider tetap menjadi acuan utama sebelum implementasi production.
1. Prompt Caching OpenAI
OpenAI menyediakan Prompt Caching pada model yang mendukung fitur tersebut. Sistem dapat menggunakan kembali prefix yang cocok sehingga pemrosesan input berulang menjadi lebih efisien.
Pada model OpenAI terbaru tertentu, developer juga memiliki kontrol terhadap cache breakpoint selain mekanisme implicit caching. Dukungan, minimum cacheable input, TTL, dan pricing dapat berbeda berdasarkan model.
Developer dapat melihat penggunaan cache melalui metadata usage yang diberikan API. Detail implementasi terbaru tersedia di dokumentasi Prompt Caching OpenAI.
2. Prompt Caching Claude
Claude menyediakan Prompt Caching untuk menggunakan kembali bagian prompt yang konsisten. Anthropic mendukung automatic caching dan explicit cache breakpoint sehingga developer dapat menyesuaikan strategi berdasarkan struktur prompt.
Claude juga memiliki mekanisme TTL yang menentukan berapa lama cache dapat digunakan kembali. Durasi, minimum token, model yang didukung, dan pricing sebaiknya selalu diperiksa sebelum implementasi.
Informasi terbaru tersedia melalui dokumentasi Prompt Caching Claude.
3. Context Caching Gemini
Gemini menggunakan istilah Context Caching untuk mekanisme yang serupa. Gemini menyediakan implicit caching pada model yang didukung serta explicit caching melalui API yang mendukung pembuatan cache secara manual.
Pada explicit caching, developer dapat membuat cache untuk context tertentu dan mereferensikannya pada request berikutnya. Dukungan caching dapat berbeda antara API, endpoint, dan model yang digunakan.
Developer dapat memeriksa detail terbaru melalui dokumentasi Context Caching Gemini.
4. Jangan Menyamakan Implementasi Antar-Provider
Konsep dasar ketiga provider tersebut serupa karena semuanya berusaha mengurangi pemrosesan ulang context yang sama. Namun, developer tidak boleh menganggap parameter dan lifecycle cache ketiganya identik.
Aplikasi multi-provider sebaiknya membuat abstraction pada level aplikasi tanpa mengasumsikan bahwa setiap provider memiliki minimum token, TTL, cache key, breakpoint, atau metadata yang sama.
Jika kamu belum familier dengan komunikasi antara aplikasi dan layanan eksternal tersebut, pembahasan apa itu API dapat membantu memahami dasar pertukaran request dan response.
Implicit Caching vs Explicit Caching
Secara umum, Prompt Caching dapat menggunakan pendekatan implicit maupun explicit. Tidak semua provider atau model menyediakan keduanya.
Implicit caching cocok ketika aplikasi ingin mendapatkan manfaat reuse tanpa mengelola lifecycle cache secara detail. Provider menentukan apakah prefix memenuhi persyaratan caching.
Explicit caching memberikan kontrol yang lebih besar ketika developer sudah mengetahui bagian context yang akan digunakan berulang. Namun, developer juga perlu mengelola konfigurasi dan lifecycle sesuai API provider.
Apa Itu Cache Hit dan Cache Miss?
Cache hit terjadi ketika provider menemukan cache atau cached prefix yang dapat digunakan untuk request saat ini. Kondisi tersebut memungkinkan sebagian pekerjaan pemrosesan input digunakan kembali.
|
1 2 3 4 5 6 7 |
Request ↓ Prefix cocok ↓ Cache Hit ↓ Cached context digunakan |
Cache miss terjadi ketika entry yang sesuai tidak tersedia atau tidak dapat digunakan. Provider kemudian perlu memproses bagian input melalui mekanisme normal.
Cache miss dapat terjadi karena beberapa kondisi, seperti request pertama, prefix berubah, cache kedaluwarsa, minimum token tidak terpenuhi, konfigurasi berubah, atau model tidak mendukung fitur caching yang digunakan.
Apa Itu TTL pada Prompt Cache?
TTL atau Time To Live menentukan masa berlaku suatu cache. Ketika masa tersebut berakhir, provider tidak lagi menjamin cache dapat digunakan untuk request selanjutnya.
Contoh sederhananya dapat digambarkan seperti berikut.
|
1 2 3 4 5 6 7 8 9 |
Cache dibuat ↓ TTL berjalan ↓ Request menggunakan cache ↓ Cache tetap tersedia sesuai aturan provider ↓ Cache kedaluwarsa |
Setiap provider memiliki kebijakan TTL yang berbeda. Beberapa provider mengatur retention secara otomatis, sedangkan provider lain memberikan opsi TTL yang dapat dikonfigurasi.
Karena itu, frekuensi request menjadi salah satu faktor yang menentukan manfaat caching. Context yang hanya digunakan sekali dalam rentang waktu panjang belum tentu mendapatkan keuntungan yang sama dengan aplikasi yang menggunakan prefix tersebut berkali-kali.
Apakah Prompt Caching Mengurangi Biaya API?
Prompt Caching dapat mengurangi biaya input jika provider memberikan harga lebih rendah untuk cached input. Namun, besarnya penghematan tidak dapat ditentukan dengan satu persentase yang berlaku untuk semua aplikasi.
Biaya dipengaruhi oleh model, pricing provider, jumlah token berulang, cache hit rate, TTL, panjang output, dan volume request. Beberapa provider juga dapat mengenakan biaya berbeda ketika cache dibuat dan ketika cache dibaca.
Output token biasanya tetap dikenakan biaya karena model masih menghasilkan jawaban baru. Oleh sebab itu, developer perlu menghitung biaya menggunakan metadata usage dan pricing provider yang benar-benar digunakan.
Apakah Prompt Caching Mengurangi Latency?
Prompt Caching dapat menurunkan waktu pemrosesan input ketika provider berhasil menggunakan kembali prefix yang panjang. Manfaat tersebut biasanya lebih terlihat pada aplikasi dengan system prompt besar, banyak example, dokumen panjang, atau tool definition yang kompleks.
Namun, caching bukan satu-satunya faktor yang menentukan response time. Panjang output, model, koneksi jaringan, tool call, database, backend, dan beban provider juga memengaruhi latency total.
Developer sebaiknya membandingkan Time to First Token dan total latency sebelum serta sesudah optimasi. Pengukuran tersebut memberikan gambaran yang lebih akurat dibanding hanya mengasumsikan bahwa setiap cache hit membuat seluruh request menjadi cepat.
Contoh Prompt Caching pada Customer Support
Bayangkan chatbot support menggunakan context berikut pada setiap request.
|
1 2 3 4 |
System Instruction: 2.000 token FAQ dan Kebijakan: 15.000 token Contoh Respons: 3.000 token Pertanyaan Pengguna: 200 token |
Total input mencapai sekitar 20.200 token. Pertanyaan pengguna dapat berubah, tetapi sekitar 20.000 token pertama mungkin tetap sama.
Provider yang mendukung caching dapat menggunakan stable prefix tersebut pada request berikutnya selama syarat cache terpenuhi.
|
1 2 3 4 5 6 7 8 9 10 11 |
Stable Prefix 20.000 token ↓ Prompt Cache + Pertanyaan Baru 200 token ↓ LLM ↓ Respons Baru |
Contoh tersebut menunjukkan mengapa aplikasi customer support menjadi salah satu kandidat Prompt Caching. Penghematan aktual tetap bergantung pada model, pricing, TTL, struktur prompt, dan keberhasilan cache hit.
Contoh Prompt Caching untuk Analisis Dokumen
Prompt Caching juga dapat berguna ketika developer menganalisis dokumen yang sama melalui banyak pertanyaan. Manual teknis yang panjang, misalnya, dapat menjadi stable context.
Request pertama dapat berbentuk seperti berikut.
|
1 2 3 4 |
Dokumen: [manual teknis panjang] Pertanyaan: Apa prosedur backup? |
Request berikutnya menggunakan dokumen yang sama tetapi mengganti pertanyaan.
|
1 2 3 4 |
Dokumen: [manual teknis panjang] Pertanyaan: Bagaimana proses restore? |
Sebagian besar context pada kedua request tersebut tetap sama. Pola seperti ini dapat menjadi kandidat caching ketika provider mendukung reuse terhadap dokumen atau prefix yang digunakan.
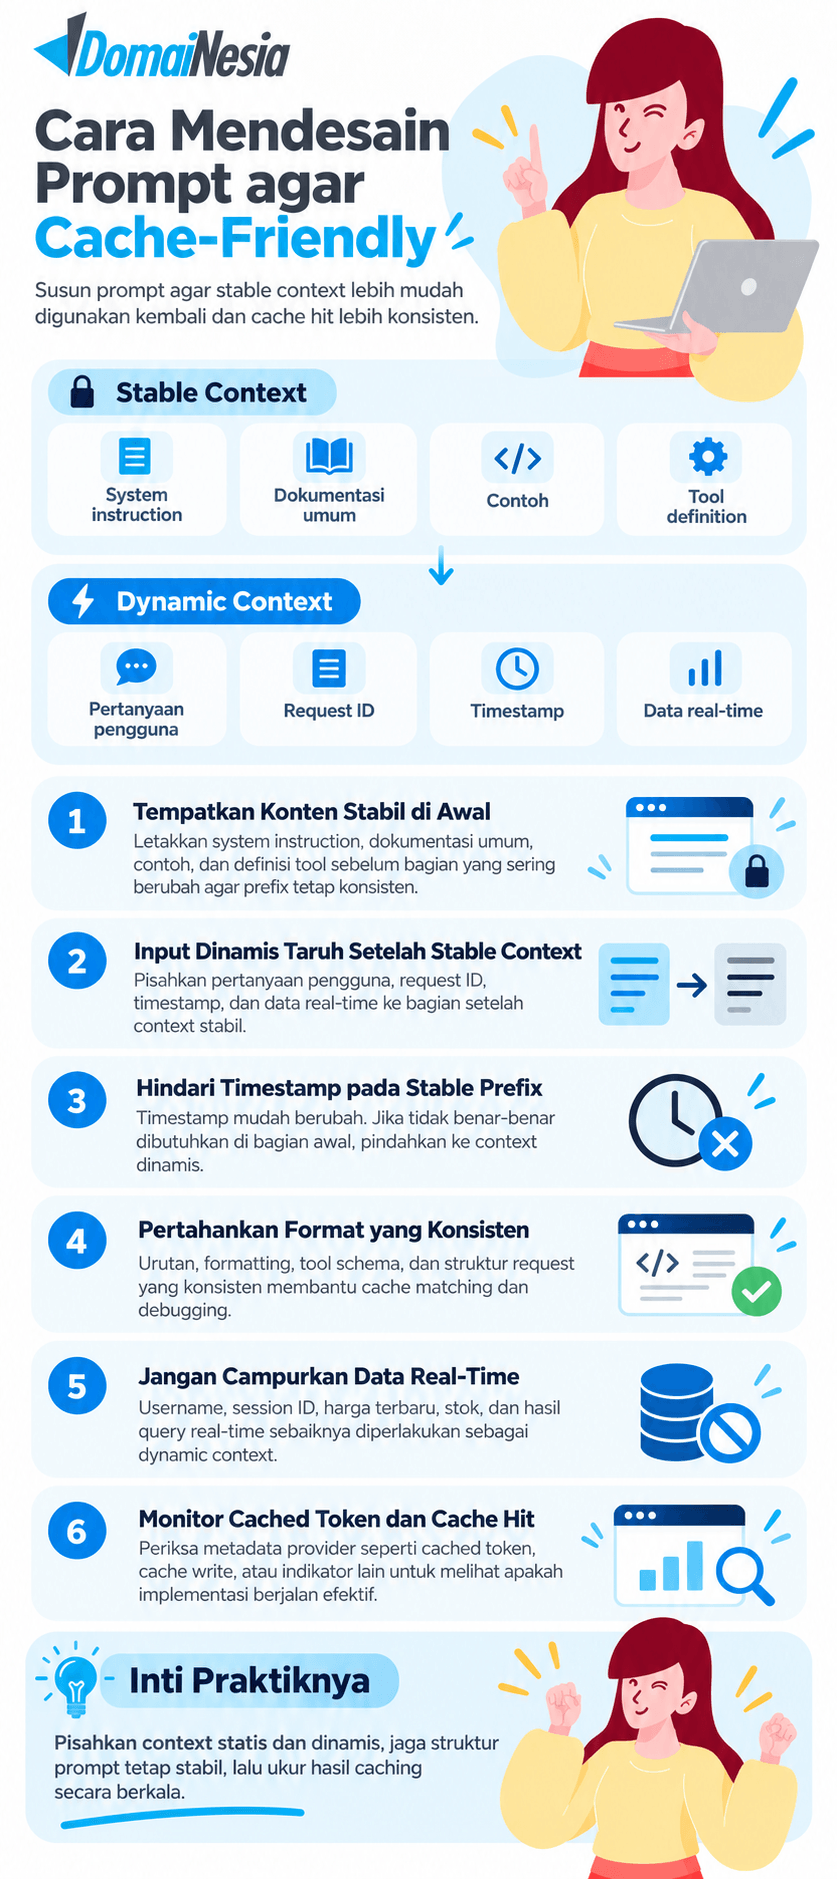
Cara Mendesain Prompt agar Cache-Friendly
Struktur prompt memiliki peran penting terhadap keberhasilan caching. Developer dapat menerapkan beberapa praktik berikut agar stable context lebih mudah digunakan kembali.
1. Tempatkan Konten Stabil di Awal
System instruction, dokumentasi umum, contoh, dan definisi tool yang tidak sering berubah dapat ditempatkan sebelum informasi dinamis. Pola tersebut membantu menjaga prefix tetap konsisten.
Developer tetap perlu menyesuaikannya dengan dokumentasi provider. Beberapa API memiliki struktur message dan cache breakpoint yang berbeda.
2. Tempatkan Input Dinamis Setelah Stable Context
Pertanyaan pengguna, request ID, timestamp, dan data real-time dapat ditempatkan setelah bagian yang ingin digunakan kembali. Penempatan tersebut mencegah perubahan data dinamis memengaruhi stable prefix terlalu dini.
Struktur ini juga membuat pemisahan antara context global dan data request menjadi lebih mudah dipahami oleh developer.
3. Hindari Timestamp pada Stable Prefix
Timestamp dapat berubah setiap detik sehingga prefix menjadi berbeda pada setiap request. Developer sebaiknya tidak memasukkannya ke bagian yang ingin dipertahankan apabila informasi waktu tidak dibutuhkan di sana.
Jika timestamp tetap diperlukan, letakkan informasi tersebut pada bagian dinamis sesuai struktur API yang digunakan.
4. Pertahankan Format yang Konsisten
Perubahan urutan, formatting, tool schema, atau bagian tertentu dalam request dapat memengaruhi cache matching. Developer sebaiknya menggunakan prompt builder yang menghasilkan stable context secara konsisten.
Prinsip tersebut juga memudahkan debugging karena perubahan prompt dapat dilacak dengan lebih jelas.
5. Jangan Campurkan Data Real-Time ke Stable Context
Data seperti username, session ID, harga terbaru, stok, maupun hasil query real-time sebaiknya diperlakukan sebagai dynamic context. Data tersebut dapat berubah dan tidak selalu relevan bagi request berikutnya.
Pemisahan antara data statis dan dinamis juga membantu aplikasi mengelola keamanan data dengan lebih baik.
6. Monitor Cached Token dan Cache Hit
Developer tidak sebaiknya menganggap implementasi berhasil hanya karena fitur caching sudah diaktifkan. Periksa metadata provider untuk mengetahui cached token, cache write, atau indikator lain yang tersedia.
Pengukuran tersebut membantu developer menemukan perubahan prompt yang menyebabkan cache miss terlalu sering.
🤖
Butuh environment fleksibel untuk menjalankan backend AI?
Cloud VPS DomaiNesia dapat digunakan untuk menjalankan API backend, worker, database, container, serta service integrasi yang menjadi penghubung antara aplikasi dan provider LLM.
Contoh Struktur Prompt yang Cache-Friendly
Sebuah coding assistant dapat membagi context berdasarkan stabilitas informasinya.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 |
1. System Instruction [STABIL] 2. Coding Standards [STABIL] 3. Repository Documentation [STABIL] 4. Tool Definitions [STABIL] 5. Current File [DINAMIS] 6. Error Message [DINAMIS] 7. User Request [DINAMIS] |
Bagian pertama hingga keempat memiliki kemungkinan reuse yang lebih tinggi. Bagian berikutnya berubah berdasarkan pekerjaan developer pada request tersebut.
Pembagian seperti ini juga membantu developer memahami bahwa Prompt Caching merupakan bagian dari strategi context management yang lebih luas.
Prompt Caching dan RAG
Prompt Caching dapat digunakan bersama Retrieval-Augmented Generation atau RAG. Developer tetap perlu membedakan context yang stabil dari hasil retrieval yang berubah berdasarkan pertanyaan.
Struktur sederhananya dapat berupa:
|
1 2 3 4 5 |
System Instruction → Stabil Format Jawaban → Stabil Tool Definition → Stabil Hasil Retrieval → Dinamis Pertanyaan Pengguna → Dinamis |
Hasil retrieval biasanya berubah karena sistem mengambil dokumen yang dianggap relevan untuk setiap query. Menempatkan seluruh hasil retrieval ke stable prefix tidak selalu menghasilkan cache reuse yang baik.
Namun, situasinya berbeda ketika aplikasi berulang kali mengajukan pertanyaan terhadap dokumen yang sama. Dokumen tersebut dapat menjadi kandidat caching sesuai dukungan provider.
Aplikasi RAG juga sering menggunakan vector database untuk menyimpan embedding dan membantu proses pencarian context relevan sebelum prompt dikirim kepada model.
Prompt Caching dan Function Calling
Aplikasi yang menggunakan banyak function atau tool dapat membawa schema yang cukup panjang. Definisi tersebut ikut menambah jumlah input yang harus diproses oleh model.
Sebagai contoh, sebuah AI Agent dapat memiliki kumpulan function berikut.
|
1 2 3 4 5 6 7 |
get_customer() get_order() create_ticket() search_documentation() check_stock() calculate_shipping() ... |
Jika definisi tool tetap sama pada banyak request, bagian tersebut dapat menjadi kandidat caching pada provider yang mendukungnya. Developer tetap perlu memeriksa apakah perubahan urutan atau schema tool dapat memengaruhi cache matching.
Caching juga tidak menggantikan optimasi arsitektur tool. Developer sebaiknya tetap memberikan tool yang relevan daripada memasukkan puluhan tool yang tidak pernah digunakan hanya karena definisinya dapat di-cache.
Prompt Caching dan Keamanan Data
Efisiensi bukan satu-satunya hal yang perlu diperhatikan ketika menerapkan Prompt Caching. Developer juga harus memahami kebijakan keamanan dan data retention provider.
1. Pahami Kebijakan Retention Provider
Setiap provider dapat memiliki mekanisme penyimpanan, TTL, dan isolasi cache yang berbeda. Developer harus membaca dokumentasi data retention sebelum memasukkan data sensitif ke request.
Kebijakan tersebut juga dapat berubah berdasarkan jenis akun, model, region, atau layanan yang digunakan.
2. Jangan Gunakan Cache sebagai Database
Prompt Cache bukan tempat penyimpanan data permanen. Data yang harus bertahan dalam jangka panjang tetap perlu disimpan pada database, object storage, memory store, atau sistem lain yang memang dirancang untuk persistence.
Aplikasi juga sebaiknya tidak menjadikan keberadaan cache sebagai dependency untuk menjaga state bisnis.
3. Hindari Data Sensitif yang Tidak Diperlukan
Prinsip data minimization tetap berlaku pada aplikasi AI. Developer sebaiknya hanya mengirim informasi yang benar-benar dibutuhkan oleh model untuk menyelesaikan tugas.
Credential, API key, password, dan secret aplikasi tidak boleh dimasukkan ke dalam prompt hanya karena context tersebut dapat digunakan kembali.
4. Perhatikan Isolasi Antar-Pengguna
Aplikasi multi-user perlu memastikan context pengguna tidak tercampur. Developer perlu memahami mekanisme account, project, workspace, cache key, atau isolation yang disediakan provider.
Jangan mengasumsikan seluruh provider menggunakan mekanisme isolasi yang sama. Implementasi harus mengikuti dokumentasi platform yang digunakan.
Cara Mengukur Keberhasilan Prompt Caching
Optimasi yang baik membutuhkan data pengukuran. Developer dapat memonitor beberapa metrik untuk mengetahui apakah Prompt Caching benar-benar memberikan manfaat.
1. Cache Hit Rate
Cache hit rate menunjukkan seberapa sering request yang menjadi kandidat caching berhasil menemukan cache. Nilai yang rendah dapat menunjukkan stable prefix terlalu sering berubah atau cache sudah kedaluwarsa sebelum digunakan kembali.
Developer perlu memahami definisi metrik dari provider karena sebagian platform lebih menekankan jumlah cached token daripada hit pada level request.
2. Cached Token
Jumlah cached token menunjukkan seberapa besar bagian input yang berhasil menggunakan cache. Metrik ini sering lebih informatif daripada hanya menghitung jumlah request.
Dua request dapat sama-sama mendapatkan cache hit tetapi menggunakan jumlah cached token yang sangat berbeda.
3. Input Cost
Developer dapat membandingkan biaya input sebelum dan sesudah optimasi. Perhitungan harus menggunakan pricing aktual untuk uncached input, cache write, dan cache read apabila provider membedakan tarif tersebut.
Biaya output tetap perlu dimasukkan ke evaluasi karena caching input tidak membuat generation menjadi gratis.
4. Time to First Token
Time to First Token atau TTFT mengukur waktu sampai model mulai memberikan output. Prompt Caching dapat membantu mengurangi waktu pemrosesan input yang panjang sehingga metrik ini relevan untuk dipantau.
Hasil pengukuran sebaiknya dibandingkan pada workload yang setara agar developer tidak menarik kesimpulan dari request yang berbeda jauh.
5. Total Latency
Total latency menghitung keseluruhan waktu yang dibutuhkan hingga respons selesai. Nilai tersebut dipengaruhi oleh cache, model, output, jaringan, database, dan tool call.
Cache hit yang baik tidak selalu menghasilkan penurunan total latency yang sama besar apabila bottleneck aplikasi berada pada komponen lain.
6. Cache Invalidation
Developer juga perlu memonitor seberapa sering perubahan prompt membuat cache tidak dapat digunakan kembali. Perubahan kecil pada bagian awal context dapat menurunkan efektivitas caching pada implementasi berbasis prefix.
Log aplikasi dapat membantu menemukan komponen dinamis yang secara tidak sengaja ditempatkan di stable context.
Hubungan Prompt Caching dengan Context Engineering
Prompt Caching merupakan salah satu teknik untuk mengoptimalkan context yang digunakan oleh LLM. Namun, teknik tersebut tidak menentukan apakah informasi dalam prompt benar-benar relevan.
Context engineering berfokus pada pemilihan informasi, waktu penggunaannya, dan bagaimana context disusun sebelum dikirim kepada model.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 |
Context Engineering ↓ Pilih informasi relevan ↓ Pisahkan context statis dan dinamis ↓ Stable Prefix ↓ Prompt Caching ↓ Dynamic Context ↓ LLM |
Prompt Caching kemudian membantu mengoptimalkan bagian context yang memang perlu digunakan berulang. Hubungan tersebut membuat kedua pendekatan saling melengkapi.
Developer sebaiknya mengurangi context yang tidak relevan terlebih dahulu. Mengirim informasi yang tidak diperlukan tetap merupakan desain yang kurang efisien meskipun token tersebut mendapatkan harga cached input.
Kapan Prompt Caching Kurang Berguna?
Prompt Caching tidak selalu memberikan manfaat yang berarti. Beberapa workload memiliki karakteristik yang membuat kemungkinan reuse relatif rendah.
Manfaat caching dapat menjadi kecil ketika prompt sangat pendek, sebagian besar input selalu berubah, request jarang dilakukan, cache sudah kedaluwarsa sebelum digunakan kembali, atau stable prefix tidak memenuhi persyaratan provider.
Sebagai contoh, aplikasi sederhana mungkin hanya mengirim prompt berikut.
|
1 2 |
Terjemahkan ke Bahasa Inggris: [input pengguna] |
Bagian yang berulang sangat pendek dibanding input dinamis. Developer sebaiknya mengukur biaya dan latency terlebih dahulu sebelum menambahkan kompleksitas caching.
Best Practice Prompt Caching
Developer dapat menggunakan prinsip berikut sebagai panduan awal saat merancang aplikasi LLM.
- Pisahkan stable context dari dynamic context agar struktur prompt lebih mudah dipertahankan.
- Tempatkan informasi yang konsisten pada bagian yang mendukung reuse sesuai mekanisme provider.
- Jangan mengubah prefix tanpa kebutuhan karena perubahan tersebut dapat meningkatkan cache miss.
- Pastikan context yang di-cache cukup besar dan cukup sering digunakan kembali agar manfaatnya sebanding.
- Periksa minimum token, TTL, pricing, dan dukungan model melalui dokumentasi provider.
- Monitor cached token, cache write, latency, dan biaya aktual setelah implementasi.
- Jangan memasukkan informasi yang tidak relevan hanya untuk memperbesar cache.
- Perhatikan data retention, privacy, serta isolasi context antar-pengguna.
- Evaluasi ulang strategi caching ketika model, provider, atau struktur aplikasi berubah.
- Gunakan caching sebagai pelengkap context optimization, bukan pengganti desain prompt yang baik.
Kapan Developer Sebaiknya Menggunakan Prompt Caching?
Prompt Caching layak dipertimbangkan ketika aplikasi membawa input panjang yang digunakan secara berulang. Chatbot dengan system instruction panjang, coding assistant, analisis dokumen, AI Agent, dan workflow dengan banyak tool merupakan beberapa contoh yang relevan.
Developer sebaiknya memulai dari pengukuran, bukan asumsi. Periksa jumlah input token, identifikasi bagian yang paling sering berulang, kemudian uji apakah cache benar-benar menurunkan biaya atau latency.
Aplikasi dengan prompt pendek dan input yang selalu berubah tidak perlu memaksakan penggunaan caching. Arsitektur yang sederhana dapat menjadi pilihan yang lebih efisien jika potensi reuse memang kecil.
Kesimpulan
Prompt Caching pada LLM merupakan mekanisme optimasi yang memungkinkan provider menggunakan kembali pemrosesan prompt atau context yang berulang. Fitur ini paling relevan untuk aplikasi yang memiliki system instruction panjang, dokumen besar, banyak few-shot example, conversation history, atau tool definition yang digunakan berkali-kali.
Namun, Prompt Caching bukan memory, tidak memperbesar context window, dan tidak membuat seluruh token menjadi gratis. Developer tetap perlu memahami cache hit, cache miss, TTL, pricing, data retention, serta mekanisme caching dari provider yang digunakan.
Mulailah dengan mengidentifikasi context yang stabil, pisahkan informasi dinamis, lalu ukur cached token, biaya, dan latency pada workload nyata. Pendekatan tersebut membantu developer menentukan apakah Prompt Caching benar-benar membuat aplikasi LLM lebih efisien tanpa mengorbankan informasi yang dibutuhkan model.
FAQ Seputar Prompt Caching pada LLM

Hiqbal Fauzi
As SEO Specialist at DomaiNesia with a bachelor's in animal husbandry, passionate about digital marketing, especially in SEO.