Structured Output AI: Cara Kerja, Schema, dan Contohnya
Oleh
Hiqbal Fauzi
Hai, DomaiNesians! Pernah meminta AI menghasilkan data dalam format JSON, tetapi struktur jawabannya berubah pada request berikutnya? Field yang sebelumnya tersedia dapat hilang, nama key bisa berubah, atau model justru menambahkan penjelasan di luar data yang dibutuhkan.
Kondisi tersebut mungkin tidak terlalu bermasalah ketika respons hanya dibaca manusia. Namun, masalahnya menjadi lebih serius ketika output AI akan langsung digunakan oleh backend, database, API, atau workflow automation.
Di sinilah Structured Output AI menjadi penting. Pendekatan ini memungkinkan developer menentukan bentuk data yang harus dihasilkan model sehingga aplikasi dapat memproses respons secara lebih konsisten.
Jika kamu belum familier dengan struktur data yang digunakan dalam contoh artikel ini, kamu dapat mempelajari terlebih dahulu format JSON agar pembahasan schema lebih mudah dipahami.
Dalam artikel ini, kita akan membahas pengertian Structured Output, cara kerjanya, fungsi schema, perbedaannya dengan JSON Mode dan Function Calling, contoh penggunaannya, hingga praktik validasi yang perlu diterapkan di backend.
Apa Itu Structured Output pada AI?
Structured Output adalah mekanisme yang memungkinkan developer meminta model AI menghasilkan data sesuai struktur atau schema yang sudah ditentukan.
Pada output teks biasa, model memiliki kebebasan yang cukup besar dalam menyusun jawaban. Model dapat memberikan informasi yang sama dengan kalimat, urutan, atau nama field yang berbeda.
Structured Output membatasi bentuk respons agar lebih mudah diprediksi oleh aplikasi.
Misalnya, sebuah aplikasi perlu menganalisis calon pelanggan dan selalu membutuhkan empat informasi, yaitu nama, kategori kebutuhan, prioritas, dan ringkasan.
Outputnya dapat dirancang seperti berikut.
|
1 2 3 4 5 6 |
{ "name": "Budi", "category": "cloud_hosting", "priority": "high", "summary": "Membutuhkan server untuk website dengan traffic tinggi." } |
Dengan struktur tersebut, backend tidak perlu mencari informasi penting dari paragraf yang dibuat AI. Aplikasi dapat langsung mengambil nilai dari category, priority, atau summary sesuai kebutuhan.
Structured Output menjadi semakin berguna ketika respons model bukan hanya dibaca pengguna, tetapi juga diteruskan ke software lain.
Mengapa Output AI Perlu Dibuat Terstruktur?
Large Language Model merupakan sistem generatif sehingga model dapat menghasilkan variasi respons meskipun informasi dasarnya serupa.
Misalnya, kamu meminta model mengklasifikasikan sebuah lead. Pada request pertama, model dapat menghasilkan:
|
1 |
Lead tersebut termasuk kategori enterprise dan sebaiknya mendapatkan prioritas tinggi. |
Pada request berikutnya, jawabannya dapat berubah menjadi:
|
1 2 |
Kategori: Enterprise Prioritas: High |
Model lainnya bahkan dapat menghasilkan:
|
1 2 3 4 |
{ "type": "enterprise", "level": "high" } |
Ketiga respons tersebut menyampaikan informasi yang hampir sama. Namun, struktur datanya berbeda sehingga backend membutuhkan aturan parsing tambahan untuk membaca masing-masing respons.
Kondisi tersebut menjadi kurang ideal ketika AI berada di dalam aplikasi produksi. Kode biasanya membutuhkan nama field, tipe data, dan struktur yang dapat diprediksi.
Dengan Structured Output, developer dapat menetapkan bentuk respons sejak awal.
|
1 2 3 4 |
{ "category": "enterprise", "priority": "high" } |
Backend kemudian mengetahui bahwa kategori selalu dibaca melalui category, sedangkan tingkat prioritas tersedia melalui priority.
Bagaimana Cara Kerja Structured Output?
Structured Output bekerja dengan menyediakan schema kepada model atau layanan AI. Schema tersebut menjelaskan struktur data, tipe nilai, field yang dibutuhkan, serta batasan lain yang didukung provider.
Secara sederhana, alurnya dapat digambarkan seperti berikut.
|
1 2 3 4 5 6 7 8 9 10 11 |
Input Pengguna ↓ Prompt + Schema ↓ LLM ↓ Structured Output ↓ Validation ↓ Backend / Database / API |
Setiap bagian pada alur tersebut memiliki fungsi yang berbeda.
1. Developer Menentukan Data yang Dibutuhkan
Developer perlu menentukan data yang benar-benar akan digunakan aplikasi sebelum membuat schema.
Misalnya, sebuah website menerima form konsultasi. Backend ingin mengubah pesan pengguna menjadi empat informasi berikut:
- Sistem perlu mengetahui kategori kebutuhan pengguna.
- Sistem perlu menentukan tingkat prioritas pesan.
- Sistem memerlukan ringkasan singkat untuk tim terkait.
- Sistem perlu mengetahui apakah pesan perlu diteruskan kepada tim sales.
Schema sederhananya dapat berbentuk seperti berikut.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 |
{ "type": "object", "properties": { "category": { "type": "string" }, "priority": { "type": "string" }, "summary": { "type": "string" }, "needs_sales": { "type": "boolean" } }, "required": [ "category", "priority", "summary", "needs_sales" ] } |
2. Pengguna Mengirim Input dalam Bahasa Alami
Pengguna tidak perlu mengikuti struktur data tersebut. Mereka tetap dapat menjelaskan kebutuhannya menggunakan bahasa sehari-hari.
Contohnya, pengguna mengirim pesan berikut.
|
1 2 3 |
Website perusahaan kami memiliki sekitar 100.000 pengunjung per bulan. Saat campaign besar, server sering overload dan kami sedang mencari solusi agar lebih stabil. |
Input tersebut tidak terstruktur karena pengguna bebas menggunakan kalimat apa pun untuk menjelaskan kebutuhannya.
3. Model Membaca Input dan Schema
LLM kemudian membaca informasi dari pengguna sekaligus aturan mengenai struktur respons.
Model mencoba memahami isi pesan dan menentukan nilai yang sesuai untuk setiap field yang tersedia.
4. Model Menghasilkan Data Terstruktur
Outputnya dapat berbentuk seperti berikut.
|
1 2 3 4 5 6 |
{ "category": "infrastructure", "priority": "high", "summary": "Membutuhkan infrastruktur yang lebih stabil untuk traffic tinggi.", "needs_sales": true } |
Aplikasi sekarang memiliki struktur yang jauh lebih mudah diproses dibandingkan respons berupa paragraf bebas.
5. Backend Memvalidasi Hasil
Structured Output tidak menghilangkan kebutuhan validasi di sisi aplikasi.
Backend tetap perlu memastikan bahwa semua field tersedia, tipe data sesuai, nilai enum diperbolehkan, aturan bisnis terpenuhi, serta data aman digunakan untuk proses berikutnya.
6. Data Diteruskan ke Sistem Berikutnya
Setelah lolos validasi, data dapat digunakan oleh database, CRM, dashboard, API, sistem notifikasi, atau workflow automation.
Structured Output akhirnya berfungsi sebagai jembatan antara bahasa manusia yang fleksibel dan software yang membutuhkan struktur data konsisten.
Apa Itu Schema dalam Structured Output?
Schema merupakan aturan yang menjelaskan bentuk data yang diharapkan dari model.
Dalam banyak implementasi Structured Output, developer dapat menggunakan konsep JSON Schema untuk menentukan tipe data, susunan object, array, field wajib, maupun pilihan nilai tertentu.
Beberapa tipe data yang umum digunakan meliputi:
objectdigunakan untuk menyimpan kumpulan field dalam pasangan key dan value.stringdigunakan untuk menyimpan data berbentuk teks.numberdigunakan untuk menyimpan angka, termasuk angka desimal.integerdigunakan ketika aplikasi membutuhkan bilangan bulat.booleandigunakan untuk menyimpan nilaitrueataufalse.arraydigunakan untuk menyimpan kumpulan beberapa item.enumdigunakan untuk membatasi nilai pada pilihan yang telah ditentukan.
Misalnya, sebuah aplikasi hanya menerima tiga tingkat prioritas. Developer dapat membatasinya melalui enum.
|
1 2 3 4 5 6 7 8 9 10 |
{ "priority": { "type": "string", "enum": [ "low", "medium", "high" ] } } |
Dengan aturan tersebut, aplikasi tidak perlu menangani terlalu banyak variasi label seperti urgent, important, very high, atau prioritas utama.
Schema yang jelas membuat kontrak data antara model dan aplikasi menjadi lebih mudah dipahami.
Structured Output vs Prompt JSON Biasa
Developer sebenarnya dapat meminta JSON hanya melalui prompt.
Contohnya, developer memberikan instruksi seperti berikut.
|
1 2 3 4 5 6 7 |
Jawab hanya menggunakan JSON. Gunakan format: { "category": "...", "priority": "..." } |
Pendekatan tersebut dapat bekerja, tetapi kepatuhan model terhadap format tetap bergantung pada instruksi yang diberikan. Model dapat menambahkan Markdown, mengganti nama field, menghilangkan field, atau memberikan teks tambahan.
Perbedaannya dapat dilihat pada tabel berikut.
Jadi, meminta model untuk “memberikan jawaban dalam JSON” tidak selalu sama dengan menggunakan Structured Output.
Structured Output vs JSON Mode
JSON Mode dan Structured Output juga sering dianggap sebagai fitur yang sama karena keduanya dapat menghasilkan JSON.
Perbedaannya terletak pada tingkat pembatasan struktur.
JSON Mode berfokus pada pembuatan respons yang dapat diproses sebagai JSON. Namun, JSON yang valid belum tentu menggunakan nama field dan tipe data yang dibutuhkan backend.
Misalnya, kedua respons berikut sama-sama dapat menjadi JSON yang valid.
|
1 2 3 4 |
{ "category": "sales", "priority": "high" } |
Respons lainnya dapat berbentuk:
|
1 2 3 4 |
{ "result": "sales", "urgency": 10 } |
Backend yang mengharapkan category dan priority tetap tidak dapat menggunakan respons kedua secara langsung.
Pada provider yang mendukung schema enforcement, Structured Output menambahkan aturan mengenai bentuk data yang harus dihasilkan, bukan sekadar memastikan sintaks JSON valid.
Structured Output vs Function Calling
Structured Output dan Function Calling sama-sama bekerja dengan data terstruktur, tetapi keduanya menyelesaikan kebutuhan yang berbeda.
Structured Output dapat digunakan untuk menghasilkan data seperti berikut.
|
1 2 3 4 5 |
{ "name": "Budi", "email": "budi@example.com", "priority": "high" } |
Data tersebut masih merupakan hasil analisis model. Aplikasi belum melakukan perubahan apa pun pada CRM.
Jika aplikasi menyediakan function tertentu, model dapat menghasilkan permintaan seperti berikut.
|
1 2 3 4 5 |
create_crm_lead( name="Budi", email="budi@example.com", priority="high" ) |
Backend kemudian memeriksa argument tersebut sebelum benar-benar menjalankan create_crm_lead().
Pada beberapa provider, Function Calling dan Structured Output bahkan dapat saling melengkapi. Schema dapat digunakan untuk memastikan argument tool mengikuti struktur yang diharapkan, sedangkan Function Calling menentukan tool yang perlu digunakan.
Konsep ini juga berkaitan dengan penggunaan tool pada AI modern. Jika kamu ingin memahami standar yang memungkinkan model berinteraksi dengan tool dan sumber eksternal, kamu dapat mempelajari Model Context Protocol (MCP).
Contoh Penggunaan Structured Output pada AI
Structured Output paling berguna ketika bahasa alami perlu diubah menjadi data yang akan diproses software.
Berikut beberapa contoh penggunaannya.
1. Memproses Form Website
Pengguna sering mengisi form dengan kalimat bebas sehingga backend sulit membuat aturan berdasarkan setiap variasi kalimat.
Misalnya, seorang pengguna menuliskan:
|
1 2 3 |
Kami ingin pindah hosting karena website sering lambat saat traffic naik. Website menggunakan WordPress dan WooCommerce. |
AI dapat mengubah informasi tersebut menjadi:
|
1 2 3 4 5 6 |
{ "issue": "performance", "platform": "wordpress", "uses_ecommerce": true, "priority": "high" } |
Backend kemudian dapat menggunakan struktur tersebut untuk routing lead atau menentukan proses berikutnya.
2. Mengekstrak Informasi dari Dokumen
Structured Output dapat digunakan ketika aplikasi perlu mengambil field tertentu dari invoice, nota, kontrak, formulir, atau dokumen lain.
Contohnya:
|
1 2 3 4 5 6 |
{ "invoice_number": "INV-1024", "vendor": "PT Contoh", "total": 2500000, "currency": "IDR" } |
Output tersebut lebih mudah dimasukkan ke database dibandingkan ringkasan invoice dalam bentuk paragraf.
3. Mengklasifikasikan Pesan Customer Support
Aplikasi customer support dapat meminta AI mengklasifikasikan pesan pelanggan menggunakan kategori yang telah ditentukan.
|
1 2 3 4 5 |
{ "category": "billing", "sentiment": "negative", "priority": "medium" } |
Backend kemudian dapat mengirim tiket ke antrean yang sesuai berdasarkan hasil klasifikasi.
4. Menganalisis Lead
AI juga dapat mengubah pesan calon pelanggan menjadi data yang lebih mudah digunakan CRM.
|
1 2 3 4 5 6 |
{ "company_size": "enterprise", "interest": "cloud_infrastructure", "budget_status": "unknown", "needs_follow_up": true } |
Sistem tetap perlu memvalidasi hasil tersebut sebelum menyimpannya atau menggunakannya untuk keputusan bisnis.
5. Membuat Metadata Konten
Content management system dapat menggunakan Structured Output untuk menghasilkan kategori, tag, kandidat slug, dan ringkasan dengan struktur konsisten.
|
1 2 3 4 5 6 7 8 9 |
{ "category": "artificial_intelligence", "tags": [ "LLM", "Structured Output", "API" ], "summary": "Penjelasan mengenai output AI terstruktur." } |
6. Mengubah Email Menjadi Task
AI assistant dapat mengekstrak action item dari email dan mengubahnya menjadi data yang dapat diteruskan ke aplikasi task management.
|
1 2 3 4 5 6 |
{ "task": "Kirim proposal revisi", "assignee": "Sales", "due_date": "2026-09-15", "priority": "high" } |
Aplikasi kemudian dapat memeriksa tanggal, pengguna, serta permission sebelum membuat task secara otomatis.
Structured Output sebagai Fondasi Workflow Automation
Workflow automation membutuhkan data yang konsisten karena setiap langkah biasanya menggunakan output dari langkah sebelumnya sebagai input.
Alurnya dapat berbentuk seperti berikut.
|
1 2 3 4 5 6 7 8 9 10 11 |
Form Website ↓ LLM ↓ Structured Output ↓ Validation ↓ CRM ↓ Notifikasi Sales |
Jika LLM menghasilkan paragraf bebas, workflow harus mencari sendiri bagian yang berisi kategori, nama, atau tingkat prioritas. Structured Output mengurangi kebutuhan parsing tersebut karena setiap informasi ditempatkan pada field yang sudah ditentukan.
Konsep ini dapat diterapkan pada platform automation seperti n8n. LLM dapat menangani bagian yang membutuhkan pemahaman bahasa, sedangkan node atau kode pada workflow tetap menangani aturan yang membutuhkan hasil deterministik.
Misalnya, backend dapat menjalankan aturan berikut.
|
1 2 |
if priority == "high": kirim_notifikasi_sales() |
AI bertugas memahami pesan pelanggan dan menghasilkan priority. Aplikasi tetap menentukan tindakan yang dilakukan berdasarkan aturan bisnis.
Jika kamu sedang membuat web app atau backend yang memproses output dari AI API, kamu juga membutuhkan environment yang mendukung stack aplikasinya. Cloud Hosting DomaiNesia dapat digunakan untuk project berbasis web dengan runtime yang didukung, sehingga kamu dapat lebih fokus pada pengembangan aplikasi daripada pengelolaan server dari nol.
Structured Output dalam Integrasi Backend dan API
Structured Output juga relevan ketika hasil AI akan diteruskan ke database atau sistem eksternal melalui API.
Misalnya, model menghasilkan data berikut.
|
1 2 3 4 5 |
{ "product_id": "HOST-01", "quantity": 2, "action": "request_quote" } |
Backend tidak boleh langsung mengirim data tersebut ke sistem berikutnya. Aplikasi perlu memeriksa apakah product_id tersedia, jumlahnya diperbolehkan, pengguna memiliki permission, serta action tersebut memang didukung.
Setelah seluruh pemeriksaan selesai, backend baru dapat meneruskannya ke API.
Jika kamu masih mempelajari mekanisme komunikasi antaraplikasi, pembahasan apa itu API dapat menjadi dasar yang relevan. Kamu juga dapat mempelajari REST API untuk memahami salah satu pola API yang banyak digunakan pada aplikasi web.
Apakah Structured Output Menjamin Data AI Selalu Benar?
Structured Output membantu menjaga bentuk data, tetapi mekanisme ini tidak otomatis menjamin isi data benar secara faktual.
Misalnya, schema meminta nilai berikut.
|
1 2 3 4 5 |
{ "invoice_total": { "type": "number" } } |
Model dapat menghasilkan:
|
1 2 3 |
{ "invoice_total": 5000000 } |
Nilai tersebut valid karena menggunakan tipe number. Namun, aplikasi tetap perlu memastikan bahwa angka Rp5.000.000 benar-benar tercantum pada invoice sumber.
Masalah yang sama berlaku untuk nama pelanggan, tanggal, kategori, ID produk, alamat, atau informasi lainnya.
Karena itu, Structured Output tidak menggantikan grounding, pemeriksaan fakta, permission, business rule, maupun human approval pada proses berisiko tinggi.
Cara Memvalidasi Structured Output di Backend
Schema yang digunakan model sebaiknya menjadi lapisan pertama, bukan satu-satunya lapisan validasi.
Pipeline yang lebih aman dapat dibuat seperti berikut.
|
1 2 3 4 5 6 7 8 9 10 11 |
LLM ↓ Structured JSON ↓ Schema Validation ↓ Business Validation ↓ Source / Permission Check ↓ Database / API / Automation |
Schema validation memeriksa apakah struktur data sesuai dengan kontrak aplikasi. Developer dapat menggunakan library seperti Zod pada JavaScript atau TypeScript dan Pydantic pada Python.
Business validation memeriksa apakah nilai yang sudah benar secara tipe juga masuk akal menurut aturan aplikasi.
Misalnya, model menghasilkan:
|
1 2 3 |
{ "discount": 500 } |
Nilai 500 memang merupakan integer yang valid. Namun, backend tetap harus menolaknya jika sistem hanya memperbolehkan diskon antara 0 hingga 100 persen.
Lapisan tambahan juga diperlukan ketika tindakan berkaitan dengan permission atau data sumber. Aplikasi harus memastikan pengguna memang memiliki izin sebelum mengubah database, memanggil API sensitif, atau menjalankan tindakan lain.
⚡
Siapkan Environment Backend untuk Integrasi AI
Jika project kamu menggunakan Node.js, Python, database, API, dan layanan AI eksternal, environment backend yang sesuai akan mempermudah proses deployment serta pengelolaannya.
Pastikan kebutuhan runtime, proses background, resource, dan arsitektur aplikasi tetap disesuaikan dengan karakter workload project kamu.
Cara Membuat Schema Structured Output yang Baik
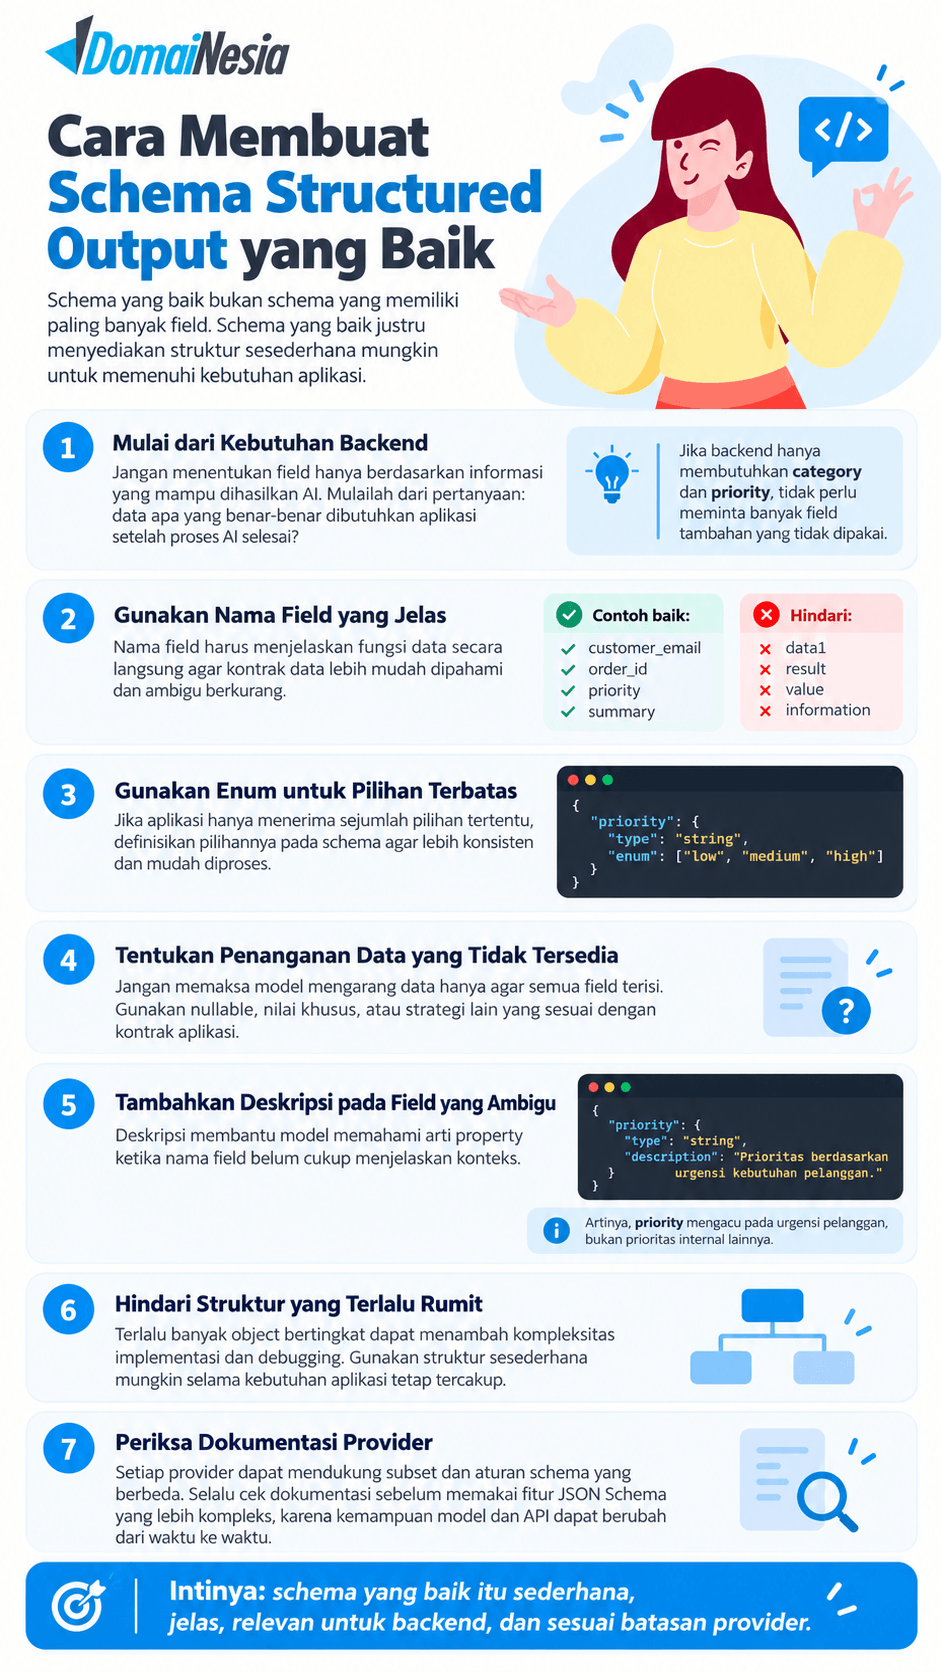
Schema yang baik bukan schema yang memiliki paling banyak field. Schema yang baik justru menyediakan struktur sesederhana mungkin untuk memenuhi kebutuhan aplikasi.
1. Mulai dari Kebutuhan Backend
Developer sebaiknya tidak menentukan field hanya berdasarkan informasi yang mampu dihasilkan AI.
Mulailah dengan pertanyaan, “Data apa yang benar-benar dibutuhkan aplikasi setelah proses AI selesai?”
Jika backend hanya membutuhkan category dan priority, aplikasi tidak perlu meminta sepuluh field tambahan yang tidak pernah digunakan.
2. Gunakan Nama Field yang Jelas
Nama field perlu menjelaskan fungsi data secara langsung.
Contoh nama yang lebih jelas meliputi:
|
1 2 3 4 |
customer_email order_id priority summary |
Hindari nama yang terlalu umum seperti:
|
1 2 3 4 |
data1 result value information |
Nama yang jelas membantu developer memahami kontrak data dan mengurangi ambiguitas saat schema dibaca oleh model.
3. Gunakan Enum untuk Pilihan Terbatas
Jika aplikasi hanya menerima sejumlah pilihan tertentu, developer sebaiknya mendefinisikannya pada schema.
|
1 2 3 4 5 6 7 8 9 10 |
{ "priority": { "type": "string", "enum": [ "low", "medium", "high" ] } } |
Pendekatan tersebut lebih mudah diproses daripada membiarkan model membuat label prioritas sendiri.
4. Tentukan Penanganan Data yang Tidak Tersedia
Input pengguna tidak selalu menyediakan seluruh informasi yang diinginkan aplikasi.
Developer sebaiknya tidak memaksa model mengarang data hanya agar setiap field memiliki nilai. Gunakan mekanisme nullable, nilai khusus, atau strategi lain yang memang didukung provider dan kontrak aplikasi.
5. Tambahkan Deskripsi pada Field yang Ambigu
Deskripsi dapat membantu model memahami arti property ketika nama field belum cukup menjelaskan konteks.
Contohnya:
|
1 2 3 4 5 6 |
{ "priority": { "type": "string", "description": "Prioritas berdasarkan urgensi kebutuhan pelanggan." } } |
Deskripsi tersebut menjelaskan bahwa priority mengacu pada urgensi pelanggan, bukan prioritas internal lainnya.
6. Hindari Struktur yang Terlalu Rumit
Schema dengan terlalu banyak object bertingkat dapat meningkatkan kompleksitas implementasi dan debugging.
Gunakan struktur yang paling sederhana selama struktur tersebut sudah mencakup kebutuhan aplikasi.
7. Periksa Dokumentasi Provider
Setiap provider dapat mendukung subset dan aturan schema yang berbeda.
Developer perlu memeriksa dokumentasi provider sebelum menggunakan fitur JSON Schema yang lebih kompleks. Praktik tersebut juga penting karena kemampuan model dan API dapat berubah dari waktu ke waktu.
Error yang Perlu Ditangani pada Structured Output
Structured Output membuat format lebih terkontrol, tetapi aplikasi tetap membutuhkan error handling.
1. Input Tidak Menyediakan Informasi yang Dibutuhkan
Dokumen atau pesan pengguna mungkin tidak memiliki informasi yang diminta schema.
Dalam kondisi tersebut, aplikasi sebaiknya menyediakan mekanisme untuk menandai informasi sebagai tidak tersedia daripada meminta model menebaknya.
2. Model Menolak Request
Provider AI dapat menghasilkan refusal ketika request melanggar kebijakan atau tidak dapat diproses.
Backend perlu membedakan kondisi tersebut dari output normal agar refusal tidak diperlakukan sebagai data bisnis biasa.
3. Output Gagal Melewati Validasi Aplikasi
Output tidak boleh langsung masuk ke database ketika business validation gagal.
Sistem dapat melakukan retry, meminta model memperbaiki hasil, atau mengalihkan kasus tertentu ke proses manual sesuai tingkat risikonya.
4. Provider API Mengalami Gangguan
Timeout, rate limit, network error, serta gangguan layanan tetap dapat terjadi meskipun aplikasi menggunakan Structured Output.
Developer tetap perlu menentukan timeout, retry strategy, logging, dan fallback sesuai kebutuhan sistem.
Kapan Sebaiknya Menggunakan Structured Output?
Structured Output cocok digunakan ketika respons AI akan diproses kembali oleh software.
Beberapa use case yang relevan meliputi ekstraksi data dokumen, klasifikasi pesan, analisis lead, pemrosesan form, pembuatan metadata, input database, argument untuk API, workflow automation, dan komunikasi antarkomponen aplikasi.
Namun, Structured Output tidak harus digunakan untuk setiap interaksi dengan AI.
Jika pengguna hanya meminta model menulis artikel, menjelaskan sebuah konsep, menyusun ide, atau membuat draft email yang langsung dibaca manusia, teks biasa biasanya lebih fleksibel dan sudah mencukupi.
Prinsip sederhananya adalah menggunakan Structured Output ketika software membutuhkan struktur yang dapat diprediksi, bukan hanya karena JSON terlihat lebih teknis.
Kesimpulan
Structured Output AI membantu developer mengubah respons LLM yang fleksibel menjadi data dengan struktur yang lebih mudah diprediksi oleh aplikasi.
Pendekatan ini sangat relevan untuk ekstraksi data, klasifikasi, pemrosesan form, analisis lead, metadata, integrasi API, hingga workflow automation. Structured Output juga mengurangi kebutuhan backend untuk menebak struktur dari teks bebas.
Namun, struktur yang valid tidak berarti isi data otomatis benar. Developer tetap perlu menggabungkan schema validation, business validation, pemeriksaan sumber, permission, error handling, dan human approval ketika tingkat risikonya membutuhkan pengawasan manusia.
Dengan pembagian tersebut, LLM dapat menangani bagian yang membutuhkan pemahaman bahasa, sedangkan backend tetap mengontrol aturan yang harus konsisten dan deterministik.
FAQ Seputar Structured Output pada AI

Hiqbal Fauzi
As SEO Specialist at DomaiNesia with a bachelor's in animal husbandry, passionate about digital marketing, especially in SEO.