Context Window pada LLM: Cara Kerja, Batas, dan Strategi Mengelolanya
Oleh
Hiqbal Fauzi
Hai DomaiNesians! Sebuah aplikasi AI dapat memiliki akses ke banyak data, tetapi LLM tidak otomatis menggunakan seluruh informasi tersebut setiap kali menghasilkan jawaban. Model hanya dapat bekerja menggunakan informasi yang tersedia dalam context pada saat proses inferensi berlangsung.
Batas informasi tersebut disebut context window. Dalam aplikasi sederhana, context mungkin hanya berisi satu pertanyaan pengguna. Namun, pada chatbot, sistem RAG, coding assistant, atau AI agent, context dapat berisi riwayat percakapan, dokumen, instruksi sistem, definisi tool, hingga hasil dari API.
Masalahnya bukan hanya seberapa besar context window yang tersedia. Developer juga harus menentukan informasi mana yang perlu dimasukkan, dipertahankan, diringkas, diambil kembali, atau dibuang.
Artikel ini membahas context window dari perspektif tersebut. Jika kamu ingin memahami dasar Large Language Model terlebih dahulu, kamu dapat membaca pembahasan LLM vs Machine Learning.
Apa Itu Context Window pada LLM?
Context window adalah batas kapasitas informasi yang dapat digunakan LLM ketika memproses suatu request dan menghasilkan respons.
Kapasitas tersebut biasanya dihitung menggunakan token. Namun, developer sebaiknya tidak melihat context window hanya sebagai batas jumlah kata karena satu request modern dapat terdiri dari banyak komponen.
Sebagai contoh, sebuah request dapat membawa:
- system instruction;
- prompt pengguna;
- riwayat percakapan;
- dokumen hasil retrieval;
- definisi tool;
- output tool sebelumnya;
- state pekerjaan;
- serta ruang yang dibutuhkan untuk menghasilkan output.
Dengan demikian, context window lebih tepat dipahami sebagai ruang kerja model selama inferensi.
Anggap sebuah aplikasi memiliki banyak informasi di database, object storage, dan knowledge base. Model tidak otomatis melihat seluruh data tersebut. Aplikasi tetap harus memilih informasi yang dibutuhkan lalu memasukkannya ke dalam context.
Token digunakan untuk mengukur berapa banyak ruang yang digunakan informasi tersebut. Satu token tidak selalu sama dengan satu kata karena proses tokenisasi dapat berbeda berdasarkan model, bahasa, karakter, dan tokenizer yang digunakan.
Karena batas token berbeda pada setiap model, developer sebaiknya memeriksa dokumentasi provider yang digunakan. Dokumentasi Gemini API mengenai token, misalnya, menjelaskan bahwa model memiliki batas input dan output yang perlu diperhatikan ketika aplikasi menyusun request.
Bagaimana Context Dibangun dalam Satu Request?
Dalam aplikasi nyata, context tidak muncul dengan sendirinya. Aplikasi membangunnya sebelum request dikirim kepada model.
Proses sederhananya dapat digambarkan seperti berikut.
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 |
Data aplikasi ↓ Pilih informasi yang relevan ↓ Susun system instruction ↓ Tambahkan chat history ↓ Tambahkan dokumen / retrieval ↓ Tambahkan tool yang diperlukan ↓ Tambahkan prompt pengguna ↓ LLM melakukan inferensi ↓ Respons / Tool Call |
Artinya, kualitas context juga dipengaruhi oleh keputusan aplikasi sebelum model mulai menghasilkan jawaban.
Misalnya, sebuah chatbot customer service sedang menangani satu pesanan pelanggan. Sistem sebenarnya memiliki data ribuan pesanan, tetapi model mungkin hanya membutuhkan identitas pelanggan, nomor pesanan yang sedang dibahas, status pengiriman, kebijakan terkait, dan beberapa pesan terakhir.
Membawa seluruh database pelanggan bukan hanya tidak diperlukan, tetapi juga dapat membuat penggunaan context menjadi tidak efisien.
Context Window sebagai Token Budget
Pendekatan lain untuk memahami context window adalah menganggapnya sebagai token budget.
Sebagai ilustrasi, satu request dapat menggunakan kapasitas seperti berikut.
Angka tersebut hanya ilustrasi, bukan rekomendasi ukuran context.
Contoh tersebut menunjukkan bahwa dokumen bukan satu-satunya komponen yang menggunakan kapasitas. Tool definition, chat history, dan instruksi sistem juga dapat menggunakan sebagian ruang yang tersedia.
Karena itu, percakapan yang semakin panjang dapat mengurangi ruang untuk dokumen atau output jika aplikasi terus mempertahankan seluruh pesan sebelumnya.
Apa yang Terjadi Ketika Context Semakin Panjang?
Context yang panjang tidak selalu menjadi masalah. Model memang dapat membutuhkan banyak informasi untuk menganalisis dokumen, memahami repository kode, atau menyelesaikan workflow kompleks.
Masalah muncul ketika aplikasi menambahkan informasi tanpa strategi yang jelas.
1. Request Bisa Mencapai Batas Model
Setiap model memiliki batas context tertentu. Jika request membutuhkan token melebihi batas yang diperbolehkan, API dapat menolak request atau aplikasi harus mengurangi informasi sebelum request dikirim.
Aplikasi biasanya menangani kondisi tersebut dengan beberapa pendekatan, seperti:
- menghapus pesan lama;
- meringkas percakapan;
- mengurangi jumlah dokumen;
- mengambil ulang hanya informasi yang relevan;
- atau membatasi tool yang tersedia.
Developer sebaiknya menangani kondisi tersebut secara eksplisit daripada menunggu request gagal ketika aplikasi sudah digunakan pengguna.
2. Informasi Penting Bisa Terkubur di Tengah Context
Meningkatkan kapasitas context tidak selalu berarti model dapat menggunakan seluruh informasi dengan efektivitas yang sama.
Penelitian Lost in the Middle menunjukkan bahwa performa beberapa model dapat berubah berdasarkan posisi informasi relevan di dalam context panjang. Pada sejumlah pengujian, informasi yang berada di bagian tertentu dari context lebih sulit dimanfaatkan dibanding informasi yang berada di awal atau akhir.
Kemampuan long-context terus berkembang dan hasilnya dapat berbeda berdasarkan model serta workload. Namun, temuan tersebut tetap memberikan pelajaran penting: memasukkan informasi ke dalam context tidak otomatis menjamin model akan menggunakan informasi tersebut secara optimal.
Developer tetap perlu melakukan retrieval, ranking, filtering, dan penyusunan context dengan baik.
3. Context Tidak Relevan Menambah Noise
Context yang besar sering kali membawa informasi yang tidak lagi dibutuhkan.
Bayangkan chatbot sudah menyelesaikan tiga masalah berbeda dalam satu percakapan. Pengguna kemudian membuka masalah keempat.
Jika aplikasi terus membawa seluruh riwayat percakapan tanpa seleksi, model harus memproses detail lama yang mungkin tidak memiliki hubungan dengan tugas terbaru.
Masalah tersebut tidak selalu menyebabkan jawaban salah, tetapi penggunaan token menjadi kurang efisien dan informasi penting dapat bersaing dengan data yang tidak relevan.
4. Informasi Lama Bisa Bertentangan dengan Informasi Baru
Context panjang juga dapat membawa informasi dengan versi berbeda.
Sebagai contoh, dokumen kebijakan lama menyebutkan satu prosedur, sementara dokumen terbaru menetapkan aturan yang berbeda. Jika aplikasi memasukkan keduanya tanpa metadata tanggal atau prioritas, model menerima dua sumber yang saling bertentangan.
Developer perlu menentukan mekanisme untuk memilih informasi terbaru atau memberikan metadata yang membantu model memahami sumber mana yang harus diprioritaskan.
Kondisi context yang tidak lengkap, ambigu, atau saling bertentangan juga dapat berhubungan dengan kualitas jawaban model. Pembahasan lebih lanjut mengenai masalah tersebut dapat kamu baca pada artikel hallucination pada LLM.
5. Biaya dan Latency Bisa Bertambah
Context yang panjang membuat model memproses lebih banyak token input.
Jika provider mengenakan biaya berdasarkan jumlah token, request yang membawa banyak informasi dapat meningkatkan biaya operasional aplikasi. Dampaknya dapat semakin besar ketika aplikasi melayani request dalam volume tinggi.
Input yang lebih panjang juga membutuhkan lebih banyak pemrosesan. Besarnya efek terhadap latency bergantung pada model dan infrastruktur provider, tetapi developer tetap perlu mempertimbangkannya pada chatbot dan aplikasi interaktif.
Dengan demikian, masalah context bukan hanya mengenai apakah informasi masih muat. Developer juga perlu mempertimbangkan relevansi, biaya, latency, serta kemampuan model menggunakan informasi tersebut.
Bagaimana Masalah Context Muncul pada Aplikasi Nyata?
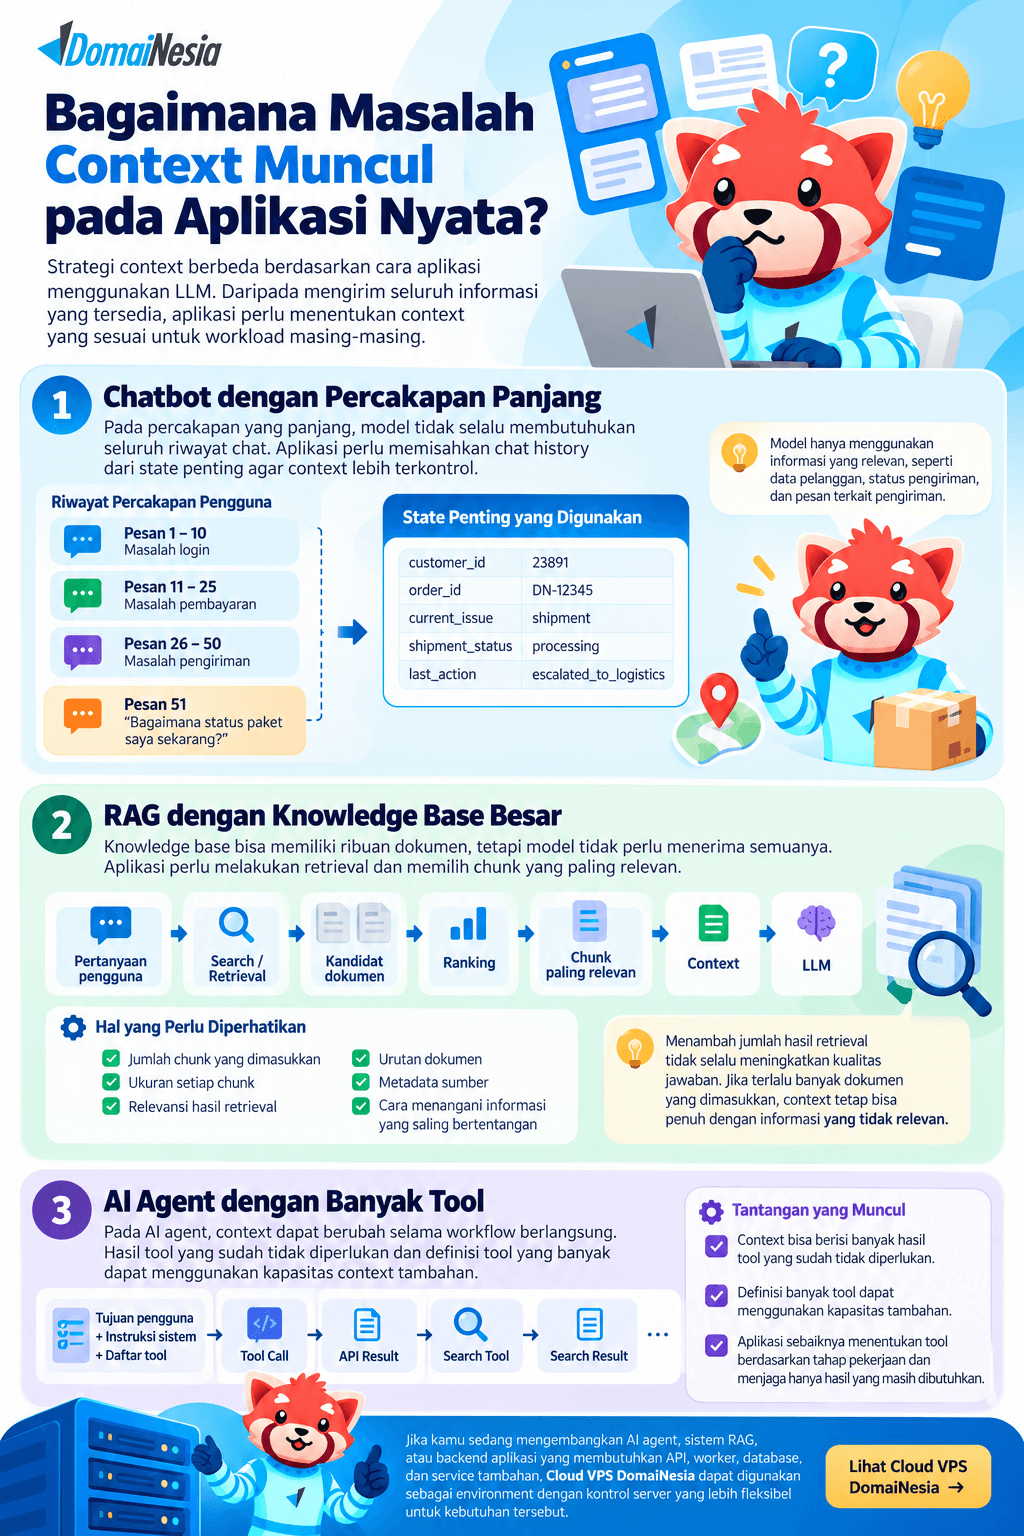
Strategi context berbeda berdasarkan cara aplikasi menggunakan LLM.
Daripada mengirim seluruh informasi yang tersedia, aplikasi perlu menentukan context yang sesuai untuk workload masing-masing.
Chatbot dengan Percakapan Panjang
Bayangkan pengguna membuka percakapan customer service seperti berikut.
|
1 2 3 4 5 6 7 8 9 10 11 |
Pesan 1–10 Masalah login Pesan 11–25 Masalah pembayaran Pesan 26–50 Masalah pengiriman Pesan 51 "Bagaimana status paket saya sekarang?" |
Untuk menjawab pesan terakhir, model mungkin membutuhkan:
|
1 2 3 4 5 6 |
customer_id order_id status pengiriman alamat tujuan pesan terkait pengiriman kebijakan pengiriman |
Model tidak selalu membutuhkan seluruh pembahasan login dan pembayaran.
Karena itu, aplikasi dapat memisahkan chat history dari state penting.
Misalnya:
|
1 2 3 4 5 |
customer_id: 23891 order_id: DN-12345 current_issue: shipment shipment_status: processing last_action: escalated_to_logistics |
State tersebut dapat dipertahankan secara terstruktur lalu dimasukkan kembali ketika diperlukan.
Pendekatan ini lebih terkontrol dibanding menjadikan seluruh percakapan sebagai satu-satunya sumber informasi.
RAG dengan Knowledge Base Besar
Permasalahan berbeda muncul ketika aplikasi menggunakan Retrieval-Augmented Generation atau RAG.
Knowledge base dapat memiliki ribuan dokumen, tetapi model tidak perlu menerima semuanya.
Workflow sederhananya dapat berbentuk:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 |
Pertanyaan pengguna ↓ Search / Retrieval ↓ Kandidat dokumen ↓ Ranking ↓ Chunk paling relevan ↓ Context ↓ LLM |
Sistem dapat menggunakan keyword search, semantic search, atau vector database untuk membantu menemukan informasi yang berkaitan dengan pertanyaan.
Namun, retrieval belum menyelesaikan seluruh masalah.
Aplikasi tetap harus menentukan:
- jumlah chunk yang dimasukkan;
- ukuran setiap chunk;
- relevansi hasil retrieval;
- urutan dokumen;
- metadata sumber;
- serta cara menangani informasi yang saling bertentangan.
Jika retrieval menghasilkan terlalu banyak dokumen, context tetap dapat dipenuhi informasi yang tidak relevan.
Karena itu, meningkatkan jumlah hasil retrieval tidak selalu meningkatkan kualitas jawaban.
AI Agent dengan Banyak Tool
AI agent menambahkan tantangan lain karena context dapat berubah selama workflow berlangsung.
Pada awal pekerjaan, agent mungkin memiliki:
|
1 2 3 4 5 |
Tujuan pengguna + Instruksi sistem + Daftar tool |
Agent kemudian memanggil API:
|
1 2 3 |
Tool Call ↓ API Result |
Hasil tersebut masuk ke workflow berikutnya.
Agent kemudian melakukan pencarian lain:
|
1 2 3 |
Search Tool ↓ Search Result |
Setelah beberapa langkah, context dapat berisi banyak hasil tool yang sebenarnya sudah tidak diperlukan.
Jika agent memiliki puluhan fungsi, definisi semua tool juga dapat menggunakan kapasitas tambahan.
Karena itu, aplikasi agent sebaiknya menentukan tool yang tersedia berdasarkan tahap pekerjaan dan mempertahankan hanya hasil yang masih dibutuhkan.
Jika kamu sedang mengembangkan AI agent, sistem RAG, atau backend aplikasi yang membutuhkan API, worker, database, dan service tambahan, Cloud VPS DomaiNesia dapat digunakan sebagai environment dengan kontrol server yang lebih fleksibel untuk kebutuhan tersebut.
Empat Strategi Mengelola Context Window
Developer tidak harus menyelesaikan masalah context hanya dengan memilih model yang memiliki kapasitas lebih besar.
Pendekatan yang lebih terkontrol adalah mengelola lifecycle informasi yang masuk ke context.
Secara sederhana, strateginya dapat dibagi menjadi selection, compression, persistence, dan refresh.
1. Selection: Pilih Informasi yang Benar-Benar Dibutuhkan
Selection menentukan data apa yang layak masuk ke dalam context.
Pada RAG, selection dapat berarti memilih beberapa chunk dengan relevance score tertinggi.
Pada coding assistant, selection dapat berarti memilih file yang memiliki hubungan dengan fungsi yang sedang mengalami error.
Pada AI agent, selection dapat berarti hanya menyediakan tool yang relevan dengan langkah pekerjaan saat ini.
Prinsip utamanya sederhana:
Context tidak harus berisi semua informasi yang tersedia. Context harus berisi informasi yang diperlukan untuk menyelesaikan pekerjaan saat ini.
Selection yang baik dapat mengurangi penggunaan token sekaligus mengurangi noise.
2. Compression: Ringkas Informasi yang Masih Penting
Beberapa informasi tetap diperlukan, tetapi tidak harus dipertahankan dalam bentuk aslinya.
Percakapan customer service sepanjang puluhan pesan, misalnya, dapat diringkas menjadi:
|
1 2 3 4 5 |
Pelanggan: Budi Order: DN-12345 Masalah: Paket belum diterima Status terakhir: Tim logistik sedang melakukan pengecekan Keputusan: Jangan membuat tiket baru |
Ringkasan tersebut membutuhkan ruang lebih sedikit dibanding seluruh percakapan.
Namun, proses summarization juga harus dilakukan dengan hati-hati.
Summary yang terlalu agresif dapat membuang detail yang ternyata dibutuhkan pada tahap berikutnya. Karena itu, aplikasi sebaiknya menentukan informasi apa yang wajib dipertahankan, seperti identitas objek, keputusan, constraint, dan status pekerjaan.
3. Persistence: Simpan State di Luar Context
Informasi penting tidak harus selalu disimpan sebagai bagian dari percakapan.
Aplikasi dapat menyimpan state di database atau sistem lain.
Contohnya:
|
1 2 3 4 5 6 7 |
user_id current_goal order_id workflow_step selected_product approval_status constraints |
Ketika informasi tersebut dibutuhkan, aplikasi dapat memasukkannya kembali ke context.
Pendekatan inilah yang membedakan context window dari memory dalam praktik aplikasi.
Context adalah informasi yang sedang digunakan model, sedangkan memory atau state adalah informasi yang disimpan agar dapat digunakan kembali.
Informasi yang disimpan di luar model tetap harus diambil dan dimasukkan kembali ke context sebelum LLM dapat menggunakannya.
Dengan cara ini, developer tidak harus mempertahankan seluruh percakapan hanya karena terdapat satu atau dua fakta penting di dalamnya.
4. Refresh: Ambil Informasi Lagi Ketika Dibutuhkan
Beberapa informasi sebaiknya tidak terus berada di context.
Developer dapat mengambil kembali data ketika model memang membutuhkannya.
Sebagai contoh, agent tidak perlu mempertahankan daftar seluruh transaksi pelanggan sepanjang workflow. Ketika pengguna menanyakan transaksi tertentu, aplikasi dapat mengambil data terbaru melalui API atau database.
Prinsip serupa berlaku pada RAG.
Dokumen knowledge base tidak harus dibawa sejak awal percakapan. Sistem dapat menjalankan retrieval setiap kali muncul pertanyaan yang membutuhkan informasi tersebut.
Pendekatan refresh memiliki keuntungan lain karena aplikasi dapat memperoleh data yang lebih baru daripada mengandalkan informasi yang sudah lama berada di context.
Menggabungkan Keempat Strategi
Empat strategi tersebut tidak harus digunakan secara terpisah.
Sebuah aplikasi dapat menjalankan alur seperti berikut:
|
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 |
User Request ↓ Retrieve data terbaru ↓ Select data relevan ↓ Compress history lama ↓ Load structured state ↓ Build Context ↓ LLM ↓ Update state |
Dengan pola tersebut, context menjadi hasil dari proses pengelolaan informasi, bukan hanya kumpulan semua data yang tersedia.
🚀
Jalankan Backend Aplikasi AI pada Environment yang Fleksibel
Aplikasi AI yang menggunakan retrieval service, database, API, worker, atau agent biasanya membutuhkan environment yang dapat dikonfigurasi sesuai arsitektur project.
Context Window dan Context Engineering
Pada titik ini, perbedaan antara context window dan context engineering menjadi lebih jelas.
Context window menentukan berapa banyak informasi yang dapat tersedia bagi model. Context engineering menentukan informasi apa yang sebaiknya menggunakan kapasitas tersebut.
Hubungannya dapat disederhanakan seperti berikut.
|
1 2 3 4 5 6 7 8 9 |
Context Window Berapa banyak informasi yang bisa digunakan ↓ Context Engineering Informasi apa yang sebaiknya diberikan ↓ Selection + Compression + Persistence + Refresh ↓ Context yang digunakan LLM |
Developer yang memiliki context window besar tetap harus menentukan:
- riwayat percakapan yang dipertahankan;
- dokumen yang dimasukkan;
- data yang diringkas;
- state yang disimpan;
- tool yang tersedia;
- hasil tool yang tetap dibawa;
- dan informasi yang perlu diambil kembali.
Dengan demikian, context window yang besar tidak menghilangkan kebutuhan untuk mengelola context.
Kamu dapat mempelajari konsep tersebut lebih lanjut melalui pembahasan apa itu Context Engineering dan Context Engineering vs Prompt Engineering.
Jangan Memilih LLM Hanya dari Context Window Terbesar
Kapasitas context tetap menjadi salah satu faktor ketika developer memilih model, tetapi angka terbesar tidak selalu berarti pilihan tersebut paling sesuai untuk workload.
Developer juga perlu mengevaluasi beberapa faktor lain.
Kualitas Long-Context
Dua model dapat menawarkan kapasitas context yang besar, tetapi kemampuan keduanya dalam menemukan dan menggunakan informasi di dalam context belum tentu sama.
Pengujian sebaiknya menggunakan workload yang menyerupai kondisi produksi, bukan hanya memastikan seluruh dokumen dapat dikirim ke API.
Biaya Input
Model dengan context besar memungkinkan developer mengirim data lebih banyak, tetapi jumlah token tersebut tetap dapat memengaruhi biaya.
Aplikasi yang memproses ribuan request perlu menghitung biaya pada skala penggunaan sebenarnya.
Latency
Kapasitas besar juga tidak berarti aplikasi harus menggunakan seluruh ruang yang tersedia.
Chatbot real-time mungkin lebih membutuhkan respons cepat daripada kemampuan menerima dokumen yang sangat panjang.
Output yang Dibutuhkan
Developer juga harus mempertimbangkan kapasitas output.
Aplikasi yang membaca dokumen panjang belum tentu membutuhkan output panjang. Sebaliknya, beberapa workflow dapat membutuhkan ruang output yang cukup besar untuk menghasilkan laporan, kode, atau data terstruktur.
Arsitektur Aplikasi
Context window juga harus dilihat bersama mekanisme retrieval, caching, tool calling, memory, dan penyimpanan state.
Model dengan kapasitas lebih kecil tetapi didukung arsitektur retrieval yang baik dapat lebih sesuai untuk workload tertentu dibanding model dengan context sangat besar yang menerima semua informasi sekaligus.
Karena itu, pengujian model sebaiknya melihat keseluruhan workflow, bukan hanya angka maksimum context window pada halaman spesifikasi.
Kesimpulan
Context window bukan sekadar angka maksimum token yang dapat diterima sebuah LLM. Dalam aplikasi nyata, context merupakan ruang kerja yang digunakan untuk membawa instruksi, percakapan, dokumen, state, tool, serta informasi lain yang dibutuhkan model ketika melakukan inferensi.
Semakin kompleks aplikasi AI, semakin penting developer mengelola informasi yang menggunakan kapasitas tersebut. Memasukkan lebih banyak data tidak selalu memberikan hasil yang lebih baik karena informasi yang tidak relevan dapat menambah noise, meningkatkan biaya, memperbesar latency, dan membuat informasi penting lebih sulit digunakan.
Pendekatan yang lebih efektif adalah mengelola lifecycle context melalui selection, compression, persistence, dan refresh. Aplikasi memilih informasi yang relevan, meringkas data lama yang masih penting, menyimpan state di luar context, lalu mengambil kembali informasi ketika model membutuhkannya.
Dengan pendekatan tersebut, developer dapat memanfaatkan context window sebagai resource yang dikelola secara terencana, bukan sekadar ruang yang harus diisi sebanyak mungkin.